
Семантическое ядро пошаговое руководство. Составление семантического ядра: пошаговая инструкция. Ошибки которые обычно допускают при составлении СЯ
Если у Вас встал вопрос «Как составить семантическое ядро», то перед решением надо сначала разобраться, с чем Вы связались.
Семантическое ядро сайта представляет собой список фраз, которые вводят пользователи в поисковых системах. Соответственно, продвигаемые страницы должны отвечать на пользовательские запросы. Разумеется, нельзя пихать на одну и ту же страницу кучу разнотипных ключевых фраз. Один основной поисковый запрос = одна страница.
Важно, чтобы ключевые слова соответствовали тематике сайта, не имели грамматических ошибок, имели вменяемую частотность, а также соответствовали по ряду других характеристик.
Семантическое ядро обычно хранится в Excel-таблице. Эту таблицу можно хранить/создать где угодно - на флешке, в Google Docs, на Яндекс.Диске либо где-то еще.
Вот наглядный пример простейшего оформления:
Особенности подбора семантического ядра сайта
Для начала следует понимать (хотя бы примерно) какие именно фразы использует Ваша аудитория при работе с поисковой системой. Этого будет вполне достаточно для работы с инструментами по подбору ключевых фраз.
Какие ключи использует аудитория
Ключи — это как раз и есть те самые фразы, которые пользователи вводят в поисковые системы для получения той или иной информации. Например, если человек хочет купить холодильник, он так и пишет - «купить холодильник», ну или «купить холодильник недорого», «купить холодильник samsung» и т.д., в зависимости от предпочтений.
Теперь давайте разбираться с признаками, по которым можно классифицировать ключи.
Признак 1 - популярность . Здесь ключи можно условно разделить на высокочастотные, среднечастотные и низкочастотные.
Низкочастотные запросы (иногда обозначаются как НЧ) имеют частоту до 100 показов в месяц, среднечастотные (СЧ) - до 1000, а высокочастотные (ВЧ) - от 1000.
Однако, эти цифры являются чисто условными, ибо есть масса исключений из этого правила. Например, тематика криптовалюты. Здесь гораздо правильнее считать низкочастотными запросы с частотой до 10000 показов в месяц, среднечастотными - от 10 до 100 тысяч, а высокочастотными - все остальное. На сегодня ключевое слово «криптовалюта» имеет частоту более 1,5 миллионов показов в месяц, а «биткоин» зашкалил за 3 миллиона.
И несмотря на то, что «криптовалюта» и «биткоин», на первый взгляд, являются очень вкусными поисковыми запросами, гораздо правильнее (как минимум на начальных этапах) делать акцент именно на низкочастотых запросах. Во-первых, потому что это более точные запросы, а значит, приготовить релевантный контент будет проще. Во-вторых, низкочастотных запросов ВСЕГДА в десятки-сотни раз больше, чем высокочастотных и среднечастотных (причем в 99,5% случаев - еще и вместе взятых). В-третьих, «низкочастотное ядро» гораздо проще и быстрее расширить, чем два других. НО… Это не значит, что СЧ и ВЧ нужно игнорировать.
Признак 2 - потребности пользователя . Здесь можно условно разделить на 3 группы:
- транзакционные - подразумевают какое-то действие (содержат в себе слова «купить», «скачать», «заказать», «доставка» и т.д.)
- информационные - просто поиск тех или иных сведений («что будет, если», «что лучше», «как правильно», «как сделать», «описание», «характеристики» и т.д.)
- прочие. Это особая категория, т.к. непонятно, чего именно хочет пользователь. Для примера возьмем запрос «торт». «Торт» что? Купить? Заказать? Испечь по рецепту? Посмотреть фотографии? Непонятно.
Теперь о применении второго признака.
Во-первых , данные запросы лучше не «смешивать». Например, у нас есть 3 поисковых запроса - «ноутбук dell 5565 amd a10 8 гб hd купить», «ноутбук dell 5565 amd a10 8 гб hd обзор» и «ноутбук dell 5565 amd a10 8 гб hd». Ключи почти полностью идентичны. Однако, именно отличия и играют решающую роль. В первом случае мы имеем «транзакционный» запрос, по которому нужно продвигать именно карточку товара. Во втором - «информационный», а в третьем - «прочий». И если по информационному ключу нужна отдельная страница, то логично задать вопрос - а что делать с третьим ключом? Очень просто - просмотреть ТОП-10 Яндекса и Google по данному запросу. Если будет много торговых предложений - значит запрос все-таки коммерческий, а если нет - значит информационный.
Во-вторых , транзакционные запросы можно условно подразделить еще и на «коммерческие» и «некоммерческие». В коммерческих запросах придется конкурировать с «тяжеловесами». Например, по запросу «купить samsung galaxy» придется конкурировать с Евросетью, Связным, по запросу «купить духовой шкаф ariston» - с М.Видео и Эльдорадо. И что делать? Очень просто - «замахиваться» на запросы, у которых гораздо более низкая частота. Например, на сегодня запрос «купить samsung galaxy» имеет частоту около 200 000 показов в месяц, в то время, как «купить samsung galaxy a8» (а это уже вполне конкретная модель линейки) имеет частоту 3600 показов в месяц. Разница в частоте громадная, но по второму запросу (именно за счет того, что подразумевается вполне конкретная модель) можно получить гораздо больше трафика, чем по первому.
Анатомия поисковых запросов
Ключевую фразу можно разбить на 3 части - тело, спецификатор, хвост.
Для наглядности возьмем уже рассмотренный ранее «прочий» запрос - «торт». Чего хочет пользователь - непонятно, т.к. он состоит только из тела и не имеет спецификатора и хвоста. Однако, он высокочастотный, а значит имеет бешеную конкуренцию в поисковой выдаче. Однако, 99,9% при посещении сайта скажет «нет, это не то, что я искал» и просто уйдет, а это негативный поведенческий фактор.
Добавим спецификатор «купить» и получаем транзакционный (а в качестве бонуса - еще и коммерческий) запрос «купить торт». Слово «купить» отражает намеренья пользователя.
Поменяем спецификатор на «фото» и получим запрос «торт фото», который уже не является транзакционным, ибо пользователь просто ищет фотографии тортов и ничего покупать не собирается.
Т.е. именно с помощью спецификатора мы и определяем какой это запрос - транзакционный, информационный или прочий.
С продажей тортов разобрались. Теперь к запросу «купить торт» добавим словосочетание «на свадьбу», которое будет являться «хвостом» запроса. Именно «хвосты» делают запросы более конкретными, более детальными, но при этом не отменяют намерений пользователя. В данном случае - раз торт свадебный, то торты с надписью «с днем рождения» отметаются сразу, т.к. они не подходят по определению.
Т.е. если взять запросы:
- купить торт на рождение ребенка
- купить торт на свадьбу
- купить торт на юбилей
то мы увидим, что цель пользователя одна и та же - «купить торт», а «на рождение ребенка», «на свадьбу» и «на юбилей» отражают потребность более детально.
Теперь, когда Вы знаете анатомию поисковых запросов, можно вывести некую формулу подбора семантического ядра. Для начала определяете некие базовые термины, имеющие прямое отношение к Вашей деятельности, а затем собираете наиболее подходящие спецификаторы и хвосты (расскажем немного позже).
Кластеризация семантического ядра
Под кластеризацией подразумевается распределение собранных ранее запросов по страницам (даже если страницы еще не созданы). Зачастую этот процесс называют «группировкой семантического ядра».
И вот тут многие допускают одну и ту же ошибку - разделять запросы нужно по смыслу, а не по количеству имеющихся страниц на сайте или в разделе. Страницы при необходимости всегда можно создать.
Теперь давайте разберемся, какие ключи куда распределять. Сделаем это на примере структуры, в которой уже есть несколько разделов и групп:
- Главная страница. Для нее отбираются только самые важные, конкурентные и высокочастотные запросы, являющиеся основой продвижения сайта в целом. («салон красоты в Санкт-Петербурге»).
- Категории услуг/товаров. Здесь вполне логично разместить запросы, не содержащие в себе особой конкретики. В случае с «салоном красоты в СПб» вполне логично создать несколько категорий по ключам «услуги визажиста», «мужской зал», «женский зал» и т.п.
- Услуги/товары. Здесь уже должны фигурировать более конкретные запросы - «свадебные прически», «маникюр», «вечерние прически», «окрашивание» и т.п. В какой-то степени это «категории внутри категории».
- Блог. Сюда подойдут информационные запросы. Их гораздо больше, чем транзакционных, поэтому и страниц, которые будут им релевантны, должно быть больше.
- Новости. Сюда выделяются ключи, наиболее подходящие для создания коротких новостных заметок.
Как выполняется кластеризация запросов
Существует 2 основных способа кластеризации - ручная и автоматическая.
У ручной кластеризации есть 2 основных минуса: долго, трудоёмко. Однако, весь процесс контролируется лично Вами, а значит можно добиться очень высокого качества. Для ручной кластеризации будет вполне достаточно Excel’я, Google Таблиц либо Яндекс.Диска. Главное - иметь возможность фильтровать и сортировать данные по тем или иным параметрам.
Многие для кластеризации используют сервис Keyword Assistant. По сути, это ручная кластеризация с элементами автоматики.
Теперь рассмотрим плюсы и минусы автоматической группировки, благо, сервисов много (как бесплатные, так и платные) и выбирать есть из чего.
Например, внимания достоин бесплатный сервис кластеризации от команды SEOintellect. Он подойдет для работы с небольшими семантическими ядрами.
Для «серьезных» объемов (несколько тысяч ключей) уже имеет смысл пользоваться платными сервисами (например, Топвизор, SerpStat и Rush Analytics). Работают они следующим образом: Вы загружаете ключевые запросы, а на выходе получаете готовы Excel-файл. Упомянутые выше 3 сервиса работают примерно по одной и той же схеме - группируют по смыслу, анализируя пересечение фраз, а также по каждому запросу просматривают ТОП-30 поисковой выдачи, чтобы выяснить, на скольких URL встречается запрашиваемая фраза. На основе вышеперечисленного и происходит распределение по группам. Происходит все это «в фоне».
Программы для создания семантического ядра
Для сбора подходящих поисковых запросов есть множество платных и бесплатных инструментов, есть из чего выбрать.
Начнем с бесплатных.
Сервис wordstat.yandex.ru. Это бесплатный сервис. Для удобства рекомендуется установить в Ваш браузер плагин Wordstat Assistant. Именно поэтому мы будем рассматривать эти 2 инструмента в паре.
Как это работает?
Очень просто.
Для примера мы соберем небольшое ядро по путевкам в Анталию. В качестве «базовых» у нас будет 2-й запрос - «туры в анталию» (в данном случае количество «базовых» запросов не принципиально).
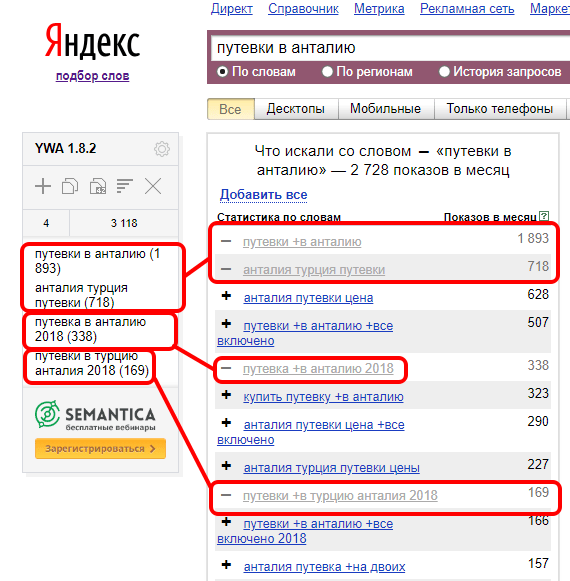
Теперь переходим по адресу https://wordstat.yandex.ru/ , логинимся, вставляем первый «базовый» запрос и получаем список ключей. Затем с помощью «плюсиков» добавляем подходящие ключи в список. Обратите внимание, если ключевая фраза окрашена в синий и слева обозначена плюсом, значит ее можно добавить в список. Если же фраза «обесцвечена» и помечена минусом - значит она в список уже добавлена, а нажатие на «минус» приведет к ее удалению из списка. Кстати, список ключей слева и плюсы-минусы - это и есть те самые фишки плагина Wordstat Assistant, без которых работа в Яндекс.Wordstat вообще не имеет смысла.
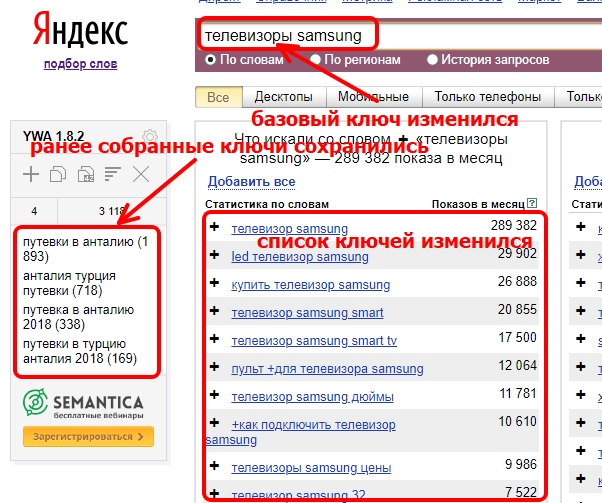
Также стоит отметить, что список будет сохранен ровно до тех пор, пока он лично Вами не будет откорректирован или очищен. Т.е. если вбить в строку «телевизоры samsung», то список ключей Яндекс.Wordstat обновится, но ранее собранные ключи в списке плагина сохранятся.
По этой схеме прогоняем через Wordstat все заранее подготовленные «базовые» ключи, собираем всё необходимое, а затем путем нажатия на одну из этих двух кнопок копируем собранный ранее список в буфер обмена. Обратите внимание, что кнопка с двумя листиками копирует список без частот, а с двумя листиками и числом 42 - с частотами.
Затем скопированный в буфер обмена список можно вставить в таблицу Excel.
Также в процессе сбора можно просмотреть статистику показов по регионам. Для этого в Яндекс.Wordstat есть вот такой переключатель.
Ну а в качестве бонуса можно глянуть историю запроса - узнать, когда частота повышалась, а когда - понижалась.
Данная фишка может быть полезна при определении сезонности запроса, а также для выявления падения/роста популярности.
Еще одной интересной фишкой является статистика показов по указанной фразе и ее формам. Для этого необходимо заключить запрос в кавычки.
Ну а если перед каждым словом добавить еще и восклицательный знак, то в статистике будет отображено количество показов по ключу без учета словоформ.
Не менее полезным является оператор «минус». Он убирает ключевые фразы, в которых содержится указанное Вами слово (или несколько слов).
Есть и еще один хитрый оператор - вертикальный разделитель. Он необходим для того, чтобы объединить сразу несколько списков ключей в один (речь про однотипные ключи). Для примера возьмем два ключа: «туры в анталию» и «путевки в анталию». В строке Яндекс.Wordstat прописываем их следующим образом и получаем на выходе 2 списка по этим ключам, объединенных в один:
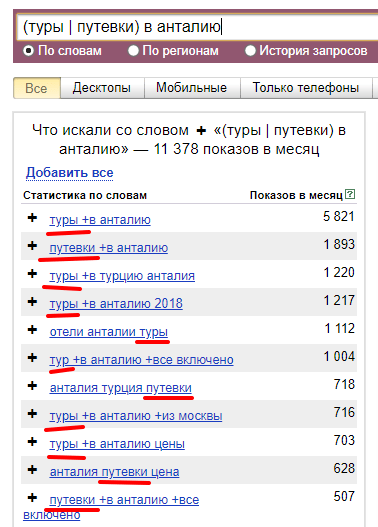
Как видите, у нас куча ключей, где есть «туры», но нет «путевок» и наоборот.
Еще одной важнейшей фишкой является привязка частоты к региону. Регион можно выбрать вот тут.
Использование Wordstat для сбора семантического ядра подойдет в том случае, если Вы собираете мини-ядра для каких-то отдельных страниц, либо не планируете больших ядер (до 1000 ключей).
SlovoEB и Key Collector
Мы не прикалываемся, программа именно так и называется. Если в двух словах, то программа позволяет делать ровно то же самое, но в автоматическом режиме.
Данная программа разработана командой LegatoSoft - та самая команда, которая разработала Key Collector, о нем тоже пойдет речь. По сути, Словоёб является сильно обрезанной (но бесплатной) версией Кей Коллектора, однако для работы со сбором небольших семантических ядер он вполне справляется.
Специально для Словоёба (или Кей Коллектора) имеет смысл создать отдельный аккаунт на Яндексе (если забанят - не жалко).
Единоразово необходимо произвести небольшие настройки.
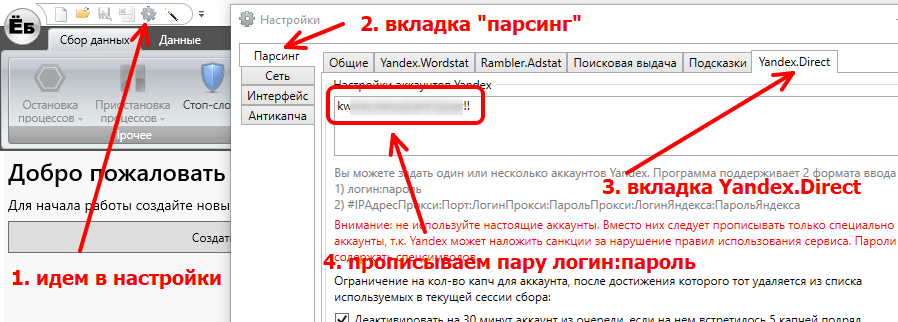
Пару логин-пароль необходимо прописывать через двоеточие и без пробелов. Т.е. если Ваш логин [email protected] и пароль 15101510ioioio, то пара будет выглядеть вот так: my_login:15101510ioioio
Обратите внимание - прописывать в логине @yandex.ru нет необходимости.
Данная настройка является единоразовым мероприятием.
Сразу проясним пару моментов:
- сколько проектов создавать для каждого сайта - решать только Вам
- без создания проекта программа работать не будет.
Теперь давайте разбираться с функционалом.
Для сбора ключей из Яндекс.Wordstat на вкладке «Сбор данных» нажимаем на кнопку «Пакетный сбор слов из левой колонки Яндекс.Wordstat», вставляем список ранее подготовленных ключевых фраз, нажимаем «Начать сбор» и ждем его окончания. Минус у такого способа сбора только один - после окончания парсинга приходится вручную удалять ненужные ключи.

На выходе мы получаем таблицу с собранными из Wordstat ключевыми словами и базовой частотой показов.
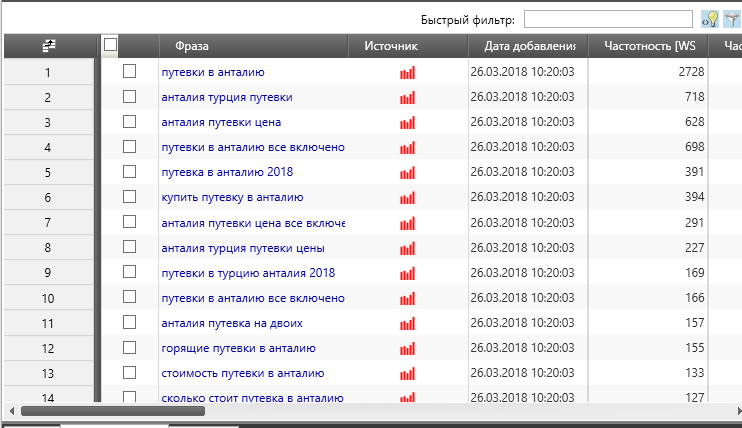
Но мы-то с Вами помним, что можно еще задействовать кавычки и восклицательный знак, верно? Этим и займемся. Тем более что данный функционал в Слоёбе реализован.
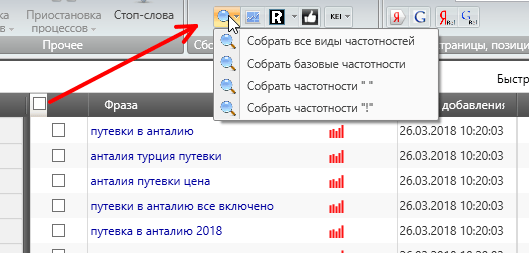
Запускаем сбор частот в кавычках и наблюдаем за тем, как данные будут постепенно появляться в таблице.
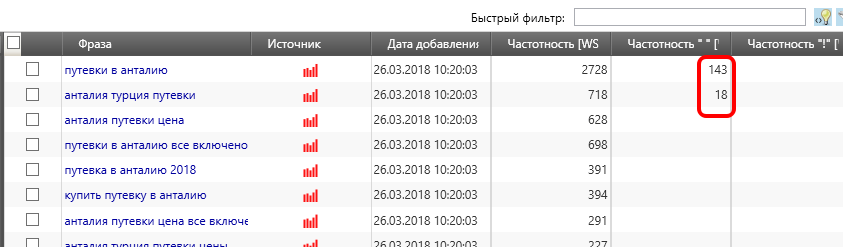
Единственный минус состоит в том, что сбор данных производится через сервис Яндекс.Wordstat, а это значит, что даже на сбор частот по 100 ключам будет уходить достаточно много времени. Однако, эта проблема решена в Key Collector’е.
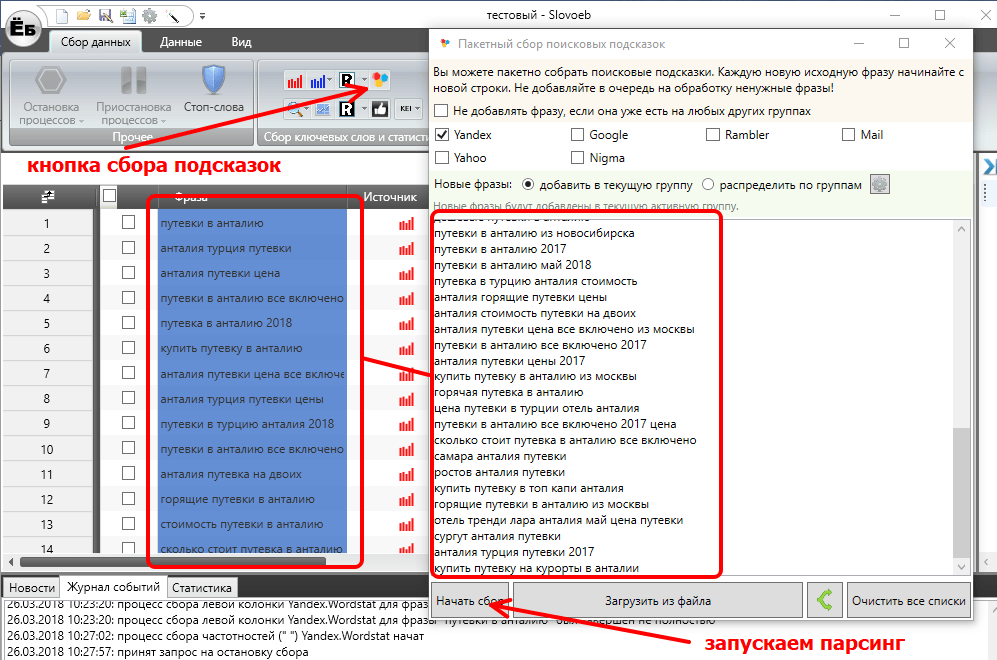
И еще одна функция, о которой хотелось бы рассказать - сбор поисковых подсказок. Для этого копируем список ранее спарсенных ключей в буфер обмена, нажимаем кнопку сбора поисковых подсказок, вставляем список, выбираем поисковые системы, с которых будет вестись сбор поисковых подсказок, нажимаем «Начать сбор» и ждем его окончания.
На выходе мы получаем расширенный список ключевых фраз.
Теперь переходим к «старшему брату» Словоёба - Key Collector’у.
Key Collector платный, но имеет гораздо более широкий функционал. Так что если Вы профессионально занимаетесь продвижением сайтов или маркетингом - Key Collector просто мастхэв, ибо Словоёба будет уже недостаточно. Если коротко, то Кей Коллектор умеет выполнять:
- Парсить ключи из Wordstat*.
- Парсить поисковые подсказки*.
- Отсечка поисковых фраз по стоп-словам*.
- Сортировка запросов по частоте*.
- Выявление запросов-дублей.
- Определение сезонных запросов.
- Сбор статистики из Liveinternet.ru, «Метрика», Google Analytics, Google AdWords, «Директ», «Вконтакте» и другие.
- Определение релевантных страниц по тому или иному запросу.
(знаком * отмечен функционал, имеющийся в Словоёбе)
Процесс сбора ключевых слов из Wordstat и сбор поисковых подсказок абсолютно идентичен тому, что реализован в Словоёбе. Однако, сбор частот реализован двумя способами - через Wordstat (как в Словоёбе) и через Директ. Через Директ сбор частот ускоряется в несколько раз.
Делается это следующим образом: нажимаем на кнопку Д (сокращение от «Директ», ставим галочку о заполнении колонок статистики Wordstat, проставляем галочки (при необходимости) о том, какую именно частоту мы хотим получить (базовую, в кавычках, или в кавычках и с восклицательными знаками», нажимаем «Получить данные» и ждем окончания сбора.
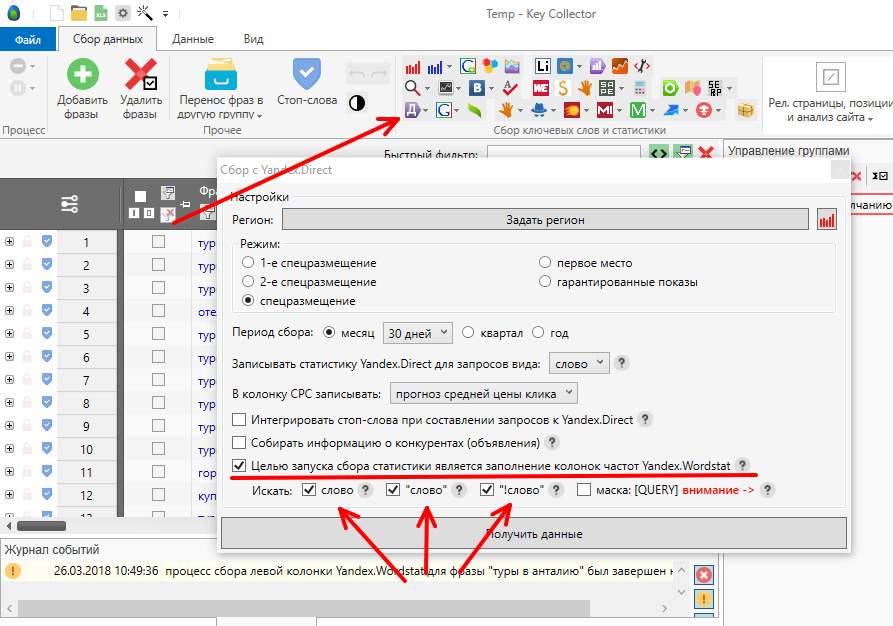
Сбор через данных Яндекс.Директ занимает гораздо меньше времени, чем через Wordstat. Однако, тут есть и один минус - статистика может быть собрана не по всем ключам (например, если ключевая фраза слишком длинная). Однако, этот минус компенсируется сбором данных из Wordstat.
Планировщик ключевых слов Google
Данный инструмент крайне полезен для сбора ядра с учетом нужд пользователей поисковой системы Google.
С помощью Планировщика ключевых слов Google можно найти новые запросы по запросам (как бы странно это ни звучало), и даже сайтам/тематикам. Ну а в качестве бонуса можно даже прогнозировать трафик и комбинировать новые поисковые запросы.
По имеющимся запросам статистику можно получить, выбрав соответствующую опцию на главной странице сервиса. При необходимости можно выбрать регион и минус-слова. Результат будет выведен в CSV-формате.
Как узнать семантическое ядро сайта конкурента
Конкуренты могут нам быть еще и друзьями, т.к. у них можно позаимствовать идеи по подбору ключевых слов. Практически по каждой странице можно получить список ключевых слов, под которые она оптимизирована, причем вручную.
Первый способ - изучить контент страницы, мета-теги Title, Description, H1 и KeyWords. Можно сделать всё вручную.
Второй способ - воспользоваться сервисами Advego или Istio. Для анализа конкретно взятых страниц этого вполне достаточно.
Если же требуется произвести комплексный анализ семантического ядра сайта, то имеет смысл воспользоваться более мощными инструментами:
- SEMrush
- Searchmetrics
- SpyWords
- Google Trends
- Wordtracker
- WordStream
- Ubersuggest
- Топвизор
Однако, приведенные выше инструменты больше подходят для тех, кто занимается профессиональным продвижением нескольких сайтов одновременно. «Для себя» даже ручного способа будет вполне достаточно (в крайнем случае - Advego).
Ошибки при составлении семантического ядра
Самая частая ошибка - очень маленькое семантическое ядро
Разумеется, если это какая-то узкоспециализированная ниша (например, ручное изготовление элитных музыкальных инструментов), то ключей при любом раскладе будет мало (сотня-полторы-две).
Чем больше семантическое ядро (но без «мусора») - тем лучше. В некоторых нишах семантическое ядро может состоять из нескольких… МИЛЛИОНОВ ключей.
Вторая ошибка - синонимайзинг. Точнее - его отсутствие
Вспомните пример с Анталией. Ведь в данном контексте «туры» и «путевки» - это одно и то же, но эти 2 списка ключей могут кардинально отличаться. «Стриппер» вполне могут искать по запросу «зачистка для проводов» или «инструмент для удаления изоляции».
Внизу поисковой выдачи у Google и Яндекса есть вот такой блок:
Именно там зачастую и можно подсмотреть синонимы.
Составление семантического ядра исключительно из ВЧ-запросов
Вспомните, что мы в начале поста говорили о низкочастотных запросах, и вопрос «а почему это ошибка?» у Вас больше не возникнет. Низкочастотные запросы как раз и будут приносить основную долю трафика.
«Мусор», т.е. нецелевые запросы
Необходимо удалить из собранного ядра все запросы, которые Вам не подходят. Если у Вас магазин сотовых телефонов, то для Вас запрос «продажа сотовых телефонов» будет целевым, а «ремонт сотовых телефонов» - мусорным. В случае с сервисным центром по ремонту сотовых телефонов все с точностью до наоборот: «ремонт сотовых телефонов» - целевой, а «продажа сотовых телефонов» - мусорный. Третий вариант - если у Вас магазин сотовых телефонов, к которому «прикреплен» сервисный центр, то оба запроса будут целевыми.
Еще раз - мусора в ядре быть не должно.
Отсутствие группировки запросов
Разбивать ядро на группы строго обязательно.
Во-первых, это позволит составить грамотную структуру сайта.
Во-вторых, не будет «ключевых конфликтов». Например, возьмем страницу, которая продвигается по запросам «купить наливной пол» и «купить ноутбук acer». Поисковая система может прийти в замешательство. В итоге будет провалено по обоим ключам. А вот по запросам «ноутбук hp 15-006 купить» и «ноутбук hp 15-006 цена» уже имеет смысл продвигать одну страницу. Более того, не просто «имеет смысл», а будет единственным правильным решением.
В-третьих, кластеризация позволит прикинуть сколько страниц еще нужно создать, чтоб ядро было охвачено полностью (а главное - нужно ли?).
Ошибки в разделении коммерческих и информационных запросов
Основная ошибка в том, что коммерческими могут оказаться и запросы, в которых нет слов «купить», «заказать», «доставка» и т.п.
Например, запрос «». Как определить, коммерческий это запрос, или информационный? Очень просто - смотрим поисковую выдачу.
Google нам говорит, что это коммерческий запрос, т.к. в выдаче у нас первые 3 позиции занимают документы со словом «купить», а на четвертой позиции хоть и расположились «отзывы», но взгляните на адрес - это достаточно известный интернет-магазин.
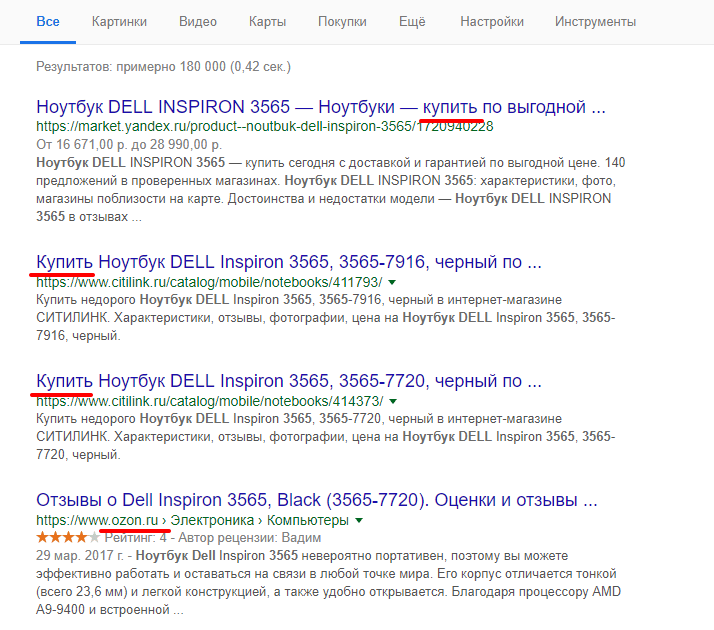
А вот с Яндексом все оказалось не так просто, т.к. в ТОП-5 у нас 3 страницы с обзорами/отзывами и 2 страницы с торговыми предложениями.
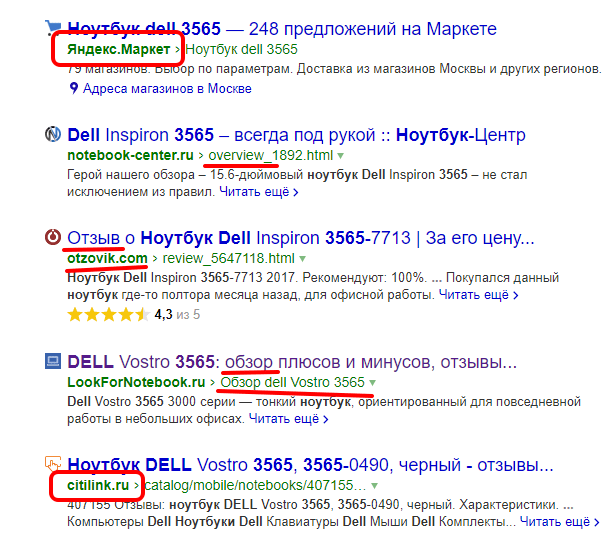
Тем не менее, данный запрос все-таки относится к коммерческим, т.к. коммерческие предложения есть и там, и там.
Однако, есть и инструмент для массовой проверки ключей на «коммерцию» - Semparser.
Подобрали «пустые» запросы
Частоты необходимо собирать и базовые, и в кавычках. Если частота в кавычках равна нулю - запрос лучше удалить, т.к. это пустышка. Нередко бывает даже так, что базовая частота превышает несколько тысяч показов в месяц, а частота в кавычках - нулевая. И сразу же конкретный пример - ключ «крем для кожи недорого». Базовая частота 1032 показа. Выглядит вкусно, правда?
Но весь вкус теряется, если пробить эту же фразу в кавычках:
Не все пользователи печатают без ошибок. Из-за них «кривые» ключевые запросы в базу и попадают. Включать их в семантические ядро бессмысленно, поскольку поисковые системы все равно перенаправляют пользователя на «исправленный» запрос.
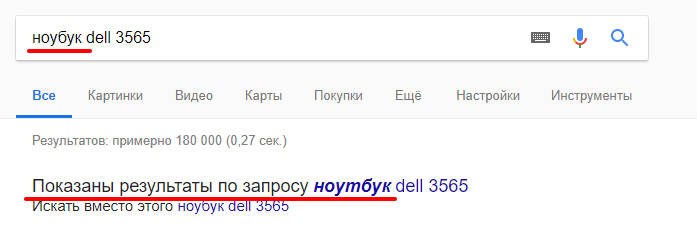
И с Яндексом ровно то же самое.
Так что «кривые» запросы (даже если они высокочастотные) удаляем без сожаления.
Пример семантического ядра сайта
Теперь переходим от теории к практике. После сбора и кластеризации семантическое ядро должно выглядеть примерно вот так:
Итог
Что же нам требуется для составления семантического ядра?
- хотя бы немного мышления бизнесмена (или хотя бы маркетолога)
- хотя бы небольшие навыки оптимизатора.
- важно уделить особое внимание структуре сайта
- прикиньте, по каким запросам пользователи могут искать нужную им информацию
- на основе «прикидок» собираете список наиболее подходящих запросов (Яндекс.Wordstat + Wordstat Assistant, Словоёб, Key Collector, Планировщик ключевых слов Google), частоты с учетом словоформ (без кавычек), а также без учета (в кавычках), удаляете «мусор».
- собранные ключи необходимо сгруппировать, т.е. распределить по страницам сайта (даже если эти страницы еще не созданы).
Нет времени? Обращайтесь к нам, мы сами все за Вас сделаем!
Мы выпустили новую книгу «Контент-маркетинг в социальных сетях: Как засесть в голову подписчиков и влюбить их в свой бренд».
Семантическое ядро сайта – это полный набор ключевых слов, соответствующих тематике веб-ресурса, по которым пользователи смогут найти его в поисковой системе.
Больше видео на нашем канале - изучайте интернет-маркетинг с SEMANTICA

К примеру, сказочный персонаж баба Яга будет иметь следующее семантическое ядро: баба Яга, баба Яга сказки, баба Яга русские сказки, баба со ступой сказки, баба со ступой и метлой, злая баба волшебница, баба избушка курьи ножки и т.д.
Для чего сайту семантическое ядро
Перед началом работ по продвижению вам необходимо найти все ключи, по которым его могут искать целевые посетители. На основании семантики составляется структура, распределяются ключи, прописываются метатеги, заголовки документов, описания к изображениям, а также разрабатывается анкор-лист для работы со ссылочной массой.
При составлении семантики необходимо решить главную проблему: определить, какую информацию следует опубликовать, чтобы привлечь потенциального клиента.
Составление списка ключей решает еще одну важную задачу: для каждой поисковой фразы вы определяете релевантную страницу, которая полно сможет ответить на вопрос пользователя.
Данная задача решается двумя путями:
- Вы создаете структуру сайта на основе семантического ядра.
- Вы распределяете подобранные термины по готовой структуре ресурса.
Виды ключевых запросов (КЗ) по количеству просмотров
- НЧ – низкочастотные. До 100 показов в месяц.
- СЧ – среднечастотные. От 101 до 1 000 показов.
- ВЧ – высокочастотные. Более 1000 показов.
По статистике, 60-80% всех фраз и слов относятся к НЧ. Работать при продвижении с ними дешевле и проще. Поэтому вы должны составить максимально объемное ядро фраз, которое будет постоянно дополняться новыми НЧ. ВЧ и СЧ также не стоит игнорировать, но основной упор делайте на расширение списка низкочастотников.
Виды КЗ по типу поиска
- Информационные нужны при поиске информации. «Как жарить картофель» или «сколько звезд на небе».
- Транзакционные используются для совершения действия. «Заказать пуховый платок», «скачать песни Высоцкого»
- Навигационные используются для поиска связанного с какой-то конкретной фирмой или привязкой к сайту. «Хлебопечь МВидео» или «смартфоны Связной».
- Прочие - расширенный список, по которому невозможно понять конечную цель поиска. К примеру, запрос «торт Наполеон» – возможно, человек ищет рецепт его приготовления, а, возможно, хочет купить торт.
Как составить семантику
Необходимо выделить главные термины вашего бизнеса и нужд пользователей. К примеру, клиенты прачечной интересуются стиркой и чисткой.
Затем следует определить хвосты и спецификацию (более 2 слов в запросе), которые пользователи добавляют к главным терминам. Этим вы увеличите охват целевой аудитории и снизите частотность терминов (стирка пледов, стирка курток и т.п.).
Сбор семантического ядра вручную
Яндекс Wordstat
- Выберите регион веб-ресурса.
- Введите ключевую фразу. Сервис выдаст вам количество запросов с данным ключевиком за последний месяц и список «родственных» терминов, которые интересовали посетителей. Имейте ввиду, что если вы вводите, к примеру, «купить окна», то получаете результаты по точному вхождению ключевика. Если вводите данный ключ без кавычек, то получаете общие результаты, и запросы типа «купить окна в воронеже» и «купить окно пластиковое» также будут отражены в данной цифре. Для сужения и уточнения показателя можно воспользоваться оператором «!», который ставится перед каждым словом: !купить!окна. Вы получите число, показывающее точную выдачу по каждому слову. Получится список типа: купить пластиковые окна, купить и заказать окна, при этом слова «купить» и «окна» будут отражаться в неизменном виде. Для получения абсолютного показателя по запросу «купить окна» следует применять следующую схему: вводим в кавычках «!купить!окна». Вы получите самые точные данные.
- Соберите слова из левой колонки и проанализируйте каждое из них. Составьте начальную семантику. Обращайте внимание на правую колонку, содержащую КЗ, которые пользователи вводили до или после поиска слов из левой колонки. Вы найдете еще немало нужных фраз.
- Пройдите по вкладке «История запросов». На графике вы сможете проанализировать сезонность, популярность фраз в каждом месяце. Неплохие результаты дает работа с поисковыми подсказками Яндекса. Каждый КЗ вводится в поисковое поле, и на основе всплывающих подсказок расширяется семантика.
Google-планировщик КЗ
- Введите главный ВЧ запрос.
- Выберите «Получить варианты».
- Отберите самые релевантные варианты.
- Повторите данной действие с каждой отобранной фразой.
Изучение сайтов-конкурентов
Используйте этот метод как дополнительный, чтобы определить правильность выбора того или иного КЗ. В этом вам помогут инструменты BuzzSumo, Searchmetrics, SEMRush, Адвсе.
Программы для составления семантического ядра
Рассмотрим некоторые самые популярные сервисы.
- Key Collector. Если вы составляете очень объемную семантику, то без этого инструмента вам не обойтись. Программа подбирает семантику, обращаясь к Яндекс Wordstat, собирает поисковые подсказки данного поисковика, фильтрует КЗ со стоп-словами, очень низкой частотой, дублированные, определяет сезонность фраз, изучает статистику счетчиков и соцсетей, подбирает релевантные страницы к каждому запросу.
- SlovoEB. Бесплатный сервис от Key Collector. Инструмент подбирает ключевые слова, группирует и анализирует их.
- Allsubmitter. Помогает подобрать КЗ, показывает сайты-конкуренты.
- KeySO. Анализирует видимость веб-ресурса, его конкурентов и помогает в составлении СЯ.
Что нужно учитывать при подборе ключевых фраз
- Показатели частотности.
- Большая часть КЗ должна быть НЧ, остальные - СЧ и ВЧ.
- Релевантные поисковым запросам страницы.
- Конкурентов в ТОП.
- Конкурентность фразы.
- Прогнозируемое количество переходов.
- Сезонность и геозависимость.
- КЗ с ошибками.
- Ассоциативные ключи.
Правильное семантическое ядро
Прежде всего, необходимо определиться с понятиями «ключевые слова», «ключи», «ключевые или поисковые запросы» – это слова или фразы, при помощи которых потенциальные клиенты вашего сайта ищут необходимую информацию.
Составьте следующие списки: категории товаров или услуг (далее -ТУ), названия ТУ их бренды, коммерческие хвосты («купить», «заказать» и т.п.), синонимы, транслитерацию на латинице (или на русском соответственно), профессиональные жаргонизмы («клавиатура» – «клава» и т.п.), технические характеристики, слова с возможными опечатками и ошибками («оренбуржский» вместо «оренбургский» и т.п.), привязки к местности (город, улицы и т.п.).
При работе со списками ориентируйтесь на КЗ из договора по продвижению, структуру веб-ресурса, информацию, прайс-листы, сайты-конкуренты, опыт предшествующего SEO.
Приступайте к подбору семантики путем смешения выбранных на предыдущем шаге словосочетаний, используя ручной метод или при помощи сервисов.
Сформируйте список стоп-слов и удалите неподходящие КЗ.
Сгруппируйте КЗ по релевантным страницам. Под каждый ключ подбирается наиболее релевантная страница или создается новый документ. Желательно данную работу проводить вручную. Для крупных проектов предусмотрены платные сервисы типа Rush Analytics.
Идите от большего к меньшему. Сначала распределите ВЧ по страницам. Затем то же самое проделайте с СЧ. НЧ можно добавить к страницам с распределенными по ним ВЧ и НЧ, а также подобрать для них индивидуальные страницы.
После анализа первых результатов работ мы можем увидеть, что:
- продвигаемый сайт не виден по всем заявленным ключевым словам;
- по КЗ выдаются не те документы, которые вы предполагали релевантными;
- мешает неправильная структура веб-ресурса;
- для некоторых КЗ релевантны несколько веб-страниц;
- не хватает релевантных страниц.
При группировке КЗ работайте со всеми возможными разделами на веб-ресурсе, наполняйте каждую страницу полезной информацией, не создавайте дублированный текст.
Распространенные ошибки при работе с КЗ
- была подобрана только очевидная семантика, без словоформ, синонимов и т.д;
- оптимизатор распределил слишком много КЗ на одну страницу;
- одинаковые КЗ распределены на разные страницы.
При этом ранжирование ухудшается, сайт может быть наказан за переспам, а если у веб-ресурса неправильная структура, то продвигать его будет очень сложно.
Не важно, каким образом вы будете подбирать семантику. При правильном подходе вы получите правильное СЯ, необходимое для успешного продвижения сайта.
Подобрать семантическое ядро - это важный этап в продвижении каждого портала в Сети. Может, немногие знают, что верно подобранные ключевые слова увеличивают эффективность рекламной акции, поднимают число целевых переходов. Однако это далеко не самое главное: качественная оптимизация только положительно воздействует на ранжировании ресурса, а это и есть основная задача каждого SEO-оптимизатора.
Что нужно узнать в самом начале?
Решили продвинуть свой портал в топ-10 или же затеяли кардинальные изменения в рубриках сайта? Тогда стоит начать действовать со сбора ключей, которые дадут вам подсказку для дальнейших действий. Что же такое семантическое ядро? Как необходимо собирать ключи для сайта и какими они должны быть для качественного продвижения? Потребуется детально разобраться с этими понятиями, чтобы иметь возможность сделать хороший СЕО-оптимизированный сайт.
Что же такое семантическое ядро?
Это определенный ряд слов, морфологических форм и словосочетаний, которые отражают смысл всего портала, и его разделов в частности. Если говорить проще, то семантическое ядро - это смысловая текстовая выжимка, его квинтэссенция. Ключевые слова отлично характеризуют вид деятельности компании, презентуют ее продукцию или услуги, а еще это приманка для поисковых систем. Что это означает? Если на вашем сайте будут использованы фразы, которые пользователи часто набирают в поисковике, то робот с большей вероятность продемонстрирует ваш сайт на первых страницах, а значит, шанс увеличить целевую аудиторию только возрастает.
С чего все начинается?
У каждой странички портала имеются свои ключевые слова, которые принимают непосредственное участие в составлении семантического ядра. Обычно СЯ странички имеет собственный главный ключевик, и чаще всего он высокочастотный, а все остальные ключевые слова лишь дополняют его, улучшая при этом релевантность текста. Данный центральный ключевой запрос обладает наивысшей частотой вхождения в текст, а дополнительные ключи только ранжируются по мере убывания.
Как собирается СЯ?
Решили узнать, как создать семантическое ядро? Тогда вам стоит сразу узнать, что от правильности формирования СЯ напрямую завит дальнейший результат по продвижению ресурса, ранжирование его по поисковых запросам и дальнейший рост трафика. Составление семантического ядра напрямую влияет на эффективность подобранной СЕО-оптимизатором стратегии. Ключи - это фундамент, на котором строится последующее продвижение ресурса.
Большие порталы могут иметь в распоряжении пару сотен ключевых слов, а маленькие интернет-сайты (к примеру, визитки) - пару ключей.
Все ключевые запросы делятся на три типа:
- высокочастотные;
- среднечастотные;
- низкочастотные.
Частотность говорит о том, как часто употребляются некоторые слова пользователями при поиске той или иной информации.
Детальней о ключах

Сразу стоит оговориться, что низкочастотные ключевые слова могут значительно поднять конверсию, приводя при этом на 100 % подходящую целевую аудиторию. Да, начинающий СЕО-оптимизатор такого вряд ли сумеет добиться, но для профессионала это сущий пустяк.
Высокочастотные ключи обогащают смысл текста (к примеру, словосочетание «заказать SEO»), а среднечастотники только служат уточнением (к примеру, словосочетание «заказать SEO в Киеве»), а вот низкочастотники максимально уточняют ваш запрос (к примеру, словосочетание «заказать SEO в Киеве недорого»). Низкочастотные ключи применяют на практике реже, чем ВЧ или СЧ ключевики, потому что запросы из списка низкочастотных слов появляются в системе довольно-таки редко, бывает до 10 раз в месяц. Однако именно НЧ приводят 100%-ную целевую аудиторию на ваш портал. Правильное семантическое ядро должно брать во внимание все ключи при сборе, чтобы создать конкурентную страничку. Если смотреть на число ключей на том или ином портале, то условно сайты можно поделить на высококонкурентные, среднеконкурентные, и низкоконкурентые.
Некоторые нюансы, о которых стоит знать
Самое главное, что стоит знать перед тем, как составить семантическое ядро, - это то, что в СЯ должны входить запросы с различной частотой. Вы не сможете создать популярный портал с одними высокочастотниками, так вы просто недополучите трафик.
Перед тем как составить семантическое ядро, постарайтесь применять на практике ключи ассоциативного вида, различные синонимы и эвфемизмы. Это необходимо для создания релевантного, интересного и привлекающего внимания текста, ведь только хороший контент принесет просмотры.
Не стоит еще забывать перед тем, как собирать семантическое ядро, что ключи должны соответствовать размерам текста, не превышая при этом допустимые нормы. Читабельность текста - обязательное условие для продвижения портала! Давно уже канули в Лету времена, когда все решали только ключевые слова и их количество, сейчас поисковые системы больше ценят информативные, релевантные описания, нацеленные на человека. Если говорить о каких-либо цифрах, то в общей сумме в тексте должно быть не более 7 % ключевых слов на весь объем.
Какие стоит использовать подходы для создания СЯ?
На первый взгляд может показаться работа СЕО-оптимизатора простой: берется список самых популярных запросов, и пишутся по ним тексты для сайта. Либо же можно взять менее популярные поисковые фразы, но добавить слово «купить». Этот подход сейчас не актуален, и вот почему.
Главный недостаток - требуется потратить немало усилий на продвижение в зоне самой высокой конкуренции, потому как другие компании додумались до этого раньше и уже воплотили идею в жизнь, а конкуренты и сейчас пытаются сделать все то же самое.
Поэтому можно сделать вывод, что списки со словами «кондиционеры» и «купить кондиционеры» просто канут в никуда и не окупятся никак. Да. В контекстной рекламе переходы будут стоит больших средств, но в поисковой оптимизации вывод сайта в топ-10 может занять много месяцев, если не годы. Тогда что же делать в итоге? Как не разориться на продвижении?
Ядра следует осуществлять при помощи «умного» подхода. Суть его состоит в том, что вы распределяете различные типы запросов в разных соотношениях. Только так можно получить больше покупателей и посетителей при небольших денежных расходах.
Какие существуют инструменты для сбора?
Вы уже узнали, как составить правильно семантическое ядро. Теперь стоит поговорить об инструментах сбора информации. Они делятся на бесплатные и платные, программы для ПК и онлайн-сервисы.
Бесплатные:
- "Яндекс Wordstat". Он позволяет установить число запросов за последний месяц по введенному ключевику.
- "Google Тренды". Демонстрируются самые востребованные тренды месячной давности.
- "Рамблер Wordstat". Функционирует по тому же принципу, что и "Яндекс Wordstat".
- Google Keyword Planner. Отличается продукт от отечественных инструментов тем, что он может не только определять рейтинг ключевика, но и получать при этом оценки их эффективности по данным значениям ставки и бюджета, прогнозы. Стоит помнить, что программа нацелена только на пользователей Google, и потому применять ее необходимо только при оптимизации для Google.
Программы для сбора и аналитики информации касательно СЯ:
- Google Analytics. Утилита позволяет получать сведения о запросах по ключевикам. Эффективность работы гарантируется связью Google Analytics с панелью вебмастера.
- "Яндекс.Метрика". Это приложение выдает перечень ключевиков, которые приводят клиентов на портал (или приводили).
- LiveInternet. Ресурс собирает большую часть сведений по ключевикам. Для лучшей эффективности часто совмещают программу с аналитическими и Google.
Платные программы для семантического ядра с уже готовыми базами данных ключей:
- "Топвизор". Это онлайн-сервис, что позволяет собирать СЯ, однако он не является лучшим на рынке. Плюсы: настроить можно таким образом, что сбор сведений будет проводится из "Яндекс.Метрики", и в автоматическом режиме будет все группироваться под существующие странички, при этом увеличивается эффективность портала. Программа также выводит статистику по пяти конкурентам по запросам, а за отдельную плату - по десятерым конкурентам.
- Key Collector. Семантическое ядро будет создаваться функциональным и максимально эффективным.
- UP Base. Это хорошая программа, у которой включен парсинг по четырем тематикам. Главное преимущество: есть как русская, так и английская база ключевиков.
- "Мутаген". Это онлайн-база ключевиков. Сервис простой в работе и поможет составить качественное семантическое ядро.
- База Макса Пастухова. Это широкая база данных по ключевикам, которая может провести создание семантического ядра сверхэффективным, при этом анализ проводить нет необходимости.
- Prodvigator.ru. Это онлайн-сервис, предназначенный для аналитики и сбора сведений по конкурентам. К сожалению, проведение кластеризации семантического ядра им крайне неудобно.
- Wordtracker. Этот инструмент предназначен для работы с англоязычными версиями порталов. Он платный, но есть и пробная бесплатная версия. Можете составить пример семантического ядра, чтобы посмотреть, подходит вам инструмент или нет.
- CS Yazzle. Это многофункциональная программа с двадцатью семью инструментами, которые позволяют составить прекрасное СЯ, раскрутить и продвинуть портал. Составьте пример семантического ядра с этой утилитой и убедитесь в ее полезности.
- Keyword Tool. Это бесплатный сервис, представленный в качестве альтернативы Google AdWords. Аккаунт для использования сервиса вам не понадобится.
Создать хорошее семантическое ядро текста - это сложный процесс, требующий усилий и труда. Бесплатные базы позволяют эффективно формировать СЯ без затруднений, главное - понимать, как ими правильно пользоваться. Если постараться, что вы сможете составить семантическое ядро бесплатно, однако платные версии имеют несколько больше возможностей, потому лучше воспользоваться ими в первую очередь, чтобы получить гарантировано нужную вам целевую аудиторию. Сложно выделить среди программ самую лучшую, это уже выбирается в индивидуальном порядке. Существуют бесплатные пробные периоды в каждой утилите, потому рекомендуется опробовать каждую, ознакомиться с возможностями всех приложений, а после выбирать понравившуюся.
Какие существуют виды поисковых запросов?
Невозможно составить верно семантическое ядро магазина, если не разбираться в Они бывают:
- Общие.
- Информационные.
- «Горячие».
- «Поиск конкурентов».
- Конкретные.
- Опечатки.
Теперь стоит остановиться на каждом типе запроса по отдельности.
Общие
Это обобщенное название чего-то. К примеру, «двери», «автомобили». Совершенно не обязательно учитывать, что человек желает что-то приобрести, возможно, ему требуется просто справочная информация касательно того или иного продукта.
Да, часть пользователей, вводящие подобные запросы, все же желают осуществить покупку, однако клиенты, видя массу статей не по теме, стараются сразу же сузить круг поиска. Второй раз они станут вводить запросы точнее и конкретней.
Если говорить о цифрах, то процент покупателей по отношению к интересующимся и «прохожим» отличается. В редких случаях он бывает больше половины, а на деле - только треть от общего числа пользователей, а то и того меньше. Потому отсев происходит огромный. Если у вас небольшая компания, то отсев может составить 70-90 % от пользователей, что вводят такой запрос.
Не забывайте: конкуренция просто огромная по таким запросам. Пробиться на вершину будет крайне трудно, хотя нет ничего невозможного.
Информационные
Это запросы в поисковике, предоставляющие справочные сведения по тому или иному продукту, мероприятию, услуге и даже, может, отрасли. Запросы не являются напрямую продающими, они только дают нужную информацию для размышлений и показывают поисковым системам, что портал подходит по «теме» продукта, услуги или мероприятия. Другими словами, система «видит», что на портале присутствует необходимая информация, что отвечает на вопросы пользователей. К примеру, «цена на обслуживание автомобиля Х», «устройство промышленного станка Y» и так далее.
Да, среди таких пользователей будут просто интересующиеся и «прохожие», но их процент к потенциальным покупателям не будет таким уж большим, если вспомнить об общих запросах.
В случае с информационными запросами важно подобрать подходящие фразы, которые необходимы потенциальному покупателю для принятия решения, что моделирует будущее. Человек должен представлять, как будет пользоваться покупкой, как изменится жизнь. Если такие моменты пользователь не способен вообразить, то он вполне может отказаться от покупки. Потому информационные запросы - это отличная почва для будущих продаж, главное - отделять правильные информационные запросы от запросов типа «как сделать N самостоятельно».
Конкретные
Это низкочастотные или среднечастотные запросы. Они имеют всегда уточнение: место, характеристики, параметры продажи и так далее. Как только пользователь вводит конкретный запрос, он подумывает о покупке, а главное, он сознательно сужает круг поиска до требуемой ему модели или предложения.
«Горячие»
Эти запросы утверждают, что человек желает совершить покупку. Покупатель вводит «купить», «цена» и другие уточняющие слова. В таком случае пользователь не думает о том, нужен ли ему товар, он уже знает, что желает купить, остается только найти место, где он сможет приобрести нужное.
Горячие запросы очень дорогие, порой даже стоят больше, нежели общие. Однако приток клиентов будет максимальным, и это все окупится, главное - соотнести расходы и прибыль. Если будущий доход покрывает траты, значит, вам стоит подумать о горячих запросах, если привлечение будет дорогим, то подыскать стоит иной тип продвижения.
«Поиск конкурентов»
Если человек вводит наименование конкурентной компании, то, скорее всего, пользователя интересует товар/услуга вашего конкурента. Если вы конкурируете, значит, работаете на одном рынке и предлагаете сопоставимые услуги/товары. Так почему не предложить пользователю узнать, что есть у вас? Лояльные клиенты не оставят компанию, потому можно не беспокоиться, что будет «отъем покупателей». Если человек недоволен сделкой с конкурентом или еще выбирает, то почему бы ему не предложить альтернативу? Самое важное - сохранять уважение к конкурирующим компаниям и не обещать того, что клиент не получит никогда.
Опечатки
Случается, что люди из-за невнимательности или на скорую руку вводят в поисковую строку запросы с ошибками, но при этом они хотят получить релевантный результат. Обычно поисковые системы исправляют ошибки, но если опечатка редкая, то поисковики могут не найти результаты и сообщить об этом пользователю. Тогда человек повторит попытку, но исправит ошибки и попадет на страницу выдачи по нужному запросу. Так вот, если в момент опечатки будет выдаваться ваш сайт, то представляете, как можно увеличить шансы получить клиента? Фактически на 100 %. Да, трафик мал по объему и кропотливый, но он фактически бесплатный и действенный.
Исключаем не целевые запросы
В СЯ вместе с тематическими целевыми запросами есть и масса смежных. Это в особенности заметно, когда высокая конкуренция на рынке. Да, смежные запросы принесут меньше трафика, но они все же положительно сказываются на продажах. Сейчас все меняется, и стоит упираться именно в целевые запросы. Большинство пользователей, переходя на портал по нецелевому запросу, фактически сразу же покидают его. Это не хорошо, но и не плохо. Однако сейчас нерелевантность странички может навредить позициям портала, потому что поисковики анализируют поведение пользователей, а если он не нашел то, что искал, то ресурс по запросу выдачи, скорее всего, опустится. Такие результаты могут навредить поведенческим метрикам, потому сейчас лучше отказаться от использования смежных запросов вовсе.
Расширяем СЯ
Расширить СЯ - это отличная возможность увеличить трафик, правда, делать это нужно не за счет высокочастотных запросов, а за счет низкочастотных. Большое СЯ может привести на портал существенный трафик целевой аудитории, однако численность запросов никак не должна мешать качеству. Не бойтесь длинных запросов, ведь они дают больше всего сведений о пользователях.
Приведем пример. Сложно представить, что именно можно предложить человеку, который набирает в поисковике слово «банки». Возможно, он ищет банк для кредита, или же ему требуется стеклянная тара. Гораздо легче понять, что интересует пользователя, если он вводит в строку поисковика «лучшие банки Москвы по ипотеке на 20 лет». Кроме того, продвижение по НЧ словам будет стоит гораздо дешевле. Некоторым сайтам и вовсе нет смысла включать потому как деятельность у них узкой направленности.
Что происходит с ВЧ запросами? Ежегодно их число неуклонно падает. Все из-за того, что продвигать порталы по ВЧ запросам непросто, ведь конкуренция огромная. Еще ВЧ запросы содержат в себе одно-два слова, а средняя длина запросов пользователя составляет примерно пять слов. Сложность состоит в том, что СЯ требуется ежемесячно увеличивать, а лучше это делать чаще. Где же взять столько НЧ запросов? Нужно проводить анализ рынка, статистики конкурентов.
О чем не стоит забывать при составлении СЯ?
- О мобильном трафике. Доля продаж посредством мобильного телефона растет постоянно, и нет никаких предпосылок к тому, что ситуация изменится. Простые программы помогут понять, какие запросы приводят на портал владельцев планшетов и смартфонов. Все дело в том, что клиенты, предпочитающие пользоваться интернетом через мобильные устройства, строят предложения несколько иначе. Их поведение на сайте отличается, потому этот рынок также нужно изучать и корректировать СЯ.
- О соцсетях. Продвижение через соцсети - это тренд, который не исчезнет в ближайшем будущем. Соцсети - это комфортная платформа для мониторинга брендов, проблем, тем, что волнуют клиентов. Имеются даже специальные сервисы, что позволяют установить популярные запросы в соцсетях.
- О конкурентах. Анализ ключевых запросов из порталов конкурентов - это полезные сведения, что позволят создать вам полезное и уникальное СЯ для продвижения своего сайта.
Как верно составить СЯ?
Процесс разработки СЯ непрост, но можно применять в работе некоторые универсальные этапы:
- Изучение специфики ниши. Потребуется выделить время на изучение бизнеса или тематики проекта. Создавайте таблицу запросов, что касаются бизнеса.
- Первичная разработка структуры портала. Создается первичный каркас сайта, где указываются все ключевые странички.
- Первичный сбор ключевиков. Получаем массив ключей, с которыми потребуется проводить дальнейшую работу.
- Анализ ключевых запросов у конкурентов. Проанализируйте структуру сайта конкурентов.
- Анализ ключевых слов. Все собранные ключевики проанализируйте, удалите лишние или расширяйте список.
- Финализация структуры сайта. Завершаются работы по формированию структуры сайта, и можно разрабатывать СЯ портала.
- Кластеризация семантического ядра. Производится группировка ключевиков по кластерам.
Что можно сказать напоследок?
Составить эффективное и действенное СЯ - это задача не из простых. Все напрямую зависит от тематики сайта, уникальности предложенных товаров, качества услуг. Всегда потребуется брать во внимание конкурентную среду, стоимость конверсии, параметры CTR и так далее. Именно потому доверить продвижение портала стоит профессиональным СЕО-специалистам, которые уже знают, как собрать семантическое ядро, и предварительно проведут глубокий анализ рынка, и сайта в частности, а после подберут необходимый инструментарий для продвижения.
Добрый день, друзья.
Наверняка вы уже забыли вкус моих статей. Предыдущий материал был довольно давно, хотя и обещал я публиковать статьи чаще, чем обычно.
В последнее время увеличилось количество работы. Создал новый проект (информационный сайт), занимался его версткой, дизайном, собирал семантическое ядро и начал публиковать материал.
Сегодня же будет очень объемный и важный материал для тех, кто ведет свой сайт более 6-7 месяцев (в некоторых тематиках более 1 года) имеет большое количество статей (в среднем 100) и еще не достиг планки минимум в 500-1000 посещений в сутки. Цифры взяты по минимуму.
Важность семантического ядра
В некоторых случаях слабый рост сайта вызван неправильной технической оптимизацией сайта. Больше случаев, когда контент некачественный. Но еще больше случаев, когда тексты пишутся вообще не под запросы - материалы никому не нужны. Но имеется еще и очень огромная часть людей, которая создает сайт, все правильно оптимизирует, пишет качественные тексты, но спустя 5-6 месяцев сайт только начинает набирать первые 20-30 посетителей с поиска. Небольшими темпами через год это уже 100-200 посетителей и цифра в доходах равняется нулю.
И хотя, все сделано правильно, нет никаких ошибок, а тексты порой даже в разы качественней конкурентов, но вот как-то не идет, хоть убей. Начинаем списывать этот косяк на отсутствие ссылок. Конечно ссылки дают буст в развитии, но это не самое главное. И без них можно через 3-4 месяца иметь 1000 посещений на сайте.
Многие скажут, что это все треп и так быстро такие цифры не получишь. Но если мы посмотрим, то не достигаются такие цифры именно на блогах. Информационные же сайты (не блоги), созданные для быстрого заработка и окупаемости вложений, примерно через 3-4 месяца вполне реально выходят на суточную посещаемость в 1000 человек, а через год – 5000-10000. Цифры конечно зависят от конкурентности ниши, ее объема и объема самого сайта на указанный срок. Но, если взять нишу с довольно небольшой конкуренцией и объемом в 300-500 материалов, то такие цифры за указанные сроки вполне достижимы.
Почему же именно блоги не достигают таких быстрых результатов? Главнейшей причиной является отсутствие семантического ядра. Из-за этого статьи пишут всего под один какой-то запрос и практически всегда под очень конкурентный, что не дает странице выбиться в ТОП за короткие сроки.
На блогах, как правило, статьи пишут по подобию конкурентов. Имеем 2- читаемых блога. Видим, что у них посещаемость приличная, начинаем анализировать их карту сайта и публиковать тексты под те же самые запросы, которые уже переписаны сотнями раз и очень конкурентные. В итоге получаем очень качественный контент на сайте, но в поиске он себя чувствует плохо, т.к. требует большого возраста. Бьемся об голову, почему же мой контент лучший, но в ТОП не пробивается?
Именно поэтому я решил написать подробный материал про семантическое ядро сайта, чтобы вы могли собрать себе список запросов и что немало важно – писали тексты под такие группы ключевых слов, которые без покупки ссылок и всего за 2-3 месяца выходили в ТОП (конечно, если контент качественный).
Материал для большинства будет сложный, если ни разу не сталкивались с этим вопросом в его правильном ключе. Но тут главное начать. Как только начинаете действовать, все сразу становится ясно.
Сделаю очень важное замечание. Касается оно тех, кто не готов вкладываться в качество своими кровными заработанными монетами и всегда пытается находить бесплатные лазейки. Семантику бесплатно качественно не соберешь и это известный факт. Поэтому, в данной статье я описываю процесс сбора семантики максимального качества. Никаких бесплатных способов или лазеек именно в этом посте не будет! Обязательно будет новый пост, где расскажу про бесплатные и другие инструменты, с помощью которых вы сможете собрать семантику, но не в полном объеме и без должного качества. Поэтому, если вы не готовы вкладываться в основу основ для вашего сайта, тогда данный материал вам ни к чему!
Несмотря на то, что практически каждый блоггер пишет статью о сем. ядре, могу с уверенностью сказать, что нет нормальных бесплатных пособий в интернете по данной теме. А если и есть, то нет такого, которое бы в полной картине давало понятие, что же должно получится на выходе.
Чаще всего ситуация заканчивается тем, что какой-то новичок пишет материал и рассказывает о сборе семантического ядра, как о применении сервиса для сбора статистика поисковых запросов от Яндекс (wordstat.yandex.ru). В конечном итоге необходимо зайти на этот сайт, вбить запросы по вашей теме, сервис выдаст список фраз, входящих в ваш вбитый ключ – это и есть вся методика.
Но на самом деле семантическое ядро собирается не так. В описанном выше случае у вас попросту не будет семантического ядра. Вы получите какие-то оторванные запросы и все они будут об одном и том же. Например, возьмем мою нишу «сайтостроение».
Какие главные запросы можно по ней без раздумий назвать? Вот лишь некоторые:
- Как создать сайт;
- Раскрутка сайта;
- Создание сайта;
- Продвижение сайта и т.д.
Запросы получаются об одном и том же. Смысл их сводится лишь к 2м понятиям: создание и раскрутка сайта.
После такой проверки сервис wordstat выдаст очень много поисковых запросов, которые входят в главные запросы и они также будут об одном и том же. Единственное их различие будет в измененных словоформах (добавление некоторых слов и изменение расположения слов в запросе с изменением окончаний).
Конечно, определенное количество текстов написать получится, так как запросы могут быть разные даже в данном варианте. Например:
- Как создать сайт wordpress;
- Как создать сайт joomla;
- Как создать сайт на бесплатном хостинге;
- Как раскрутить сайт бесплатно;
- Как раскрутить сайт сервис и т.д.
Очевидно, что под каждый запрос можно выделить отдельный материал. Но такое составление семантического ядра сайта не увенчается успехом, т.к. не будет полноты раскрытия информации на сайте в выбранной нише. Весь контент будет лишь о 2х темах.
Иногда блоггеры-новички описывают процесс составления семантического ядра, как анализ отдельных запросов в сервисе анализа запросов Яндекс Вордстат. Вбиваем какой-то отдельный запрос, относящийся не к теме в целом, а лишь к определенной статье (например, как оптимизировать статью), получаем по нему частотность и вот оно – семантическое ядро собирается. Получается, что таким образом мы должны умственно определить всевозможные темы статей и проанализировать их.
Оба вышеописанные варианты неправильные, т.к. не дают полного семантического ядра и заставляют постоянно возвращаться к его составлению (второй вариант). К тому же вы не будете иметь на руках вектор развития сайта и не сможете в первую очередь публиковать материалы, которые и нужно размещать в числе первых.
Касаемо первого варианта, то покупая когда-то курсы по раскрутке сайтов, я постоянно видел именно такое объяснение сбора ядра запросов для сайта (вбить главные ключ и скопировать все запросы из сервиса в текстовый документ). В итоге меня постоянно мучал вопрос «А что же делать с такими запросами?» На ум приходило следующее:
- Писать много статей об одном и том же, но употребляя разные ключевые слова;
- Все эти ключи вписывать в поле description к каждому материалу;
- Вписать все ключи из сем. ядра в общее поле description ко всему ресурсу.
Ни одно из этих предположений не было верным, как в общем-то и само составленное семантическое ядро сайта.
На окончательном варианте сбора семантического ядра мы должны получит не просто список запросов в количестве 10000, например, а иметь на руках список групп запросов, каждая из которых используется для отдельной статьи.
Группа может содержать от 1 до 20-30 запросов (иногда 50, а то и больше). В таком случае в тексте мы употребляем все эти запросы и страница в перспективе ежедневно будет приносить трафик по всем запросам, если попадет на 1-3 позиции в поиске. Кроме этого, каждая группа должна иметь свою конкуренцию, чтобы знать, имеет ли смысл сейчас публиковать по ней текст или нет. Если конкуренция большая, тогда можем ожидать эффект от страницы только через 1-1.5 года и с проведением регулярных работ по ее продвижению (ссылки, перелинковка и т.д.). Поэтому, лучше на такие тексты делать упор в самую последнюю очередь, даже если они самые трафиковые.
Ответы на возможные вопросы
Вопрос №1. Понятно, что на выходе получаем группу запросов для написания текста, а не всего один ключ. Не будут ли похожи в этом случае ключи между собой и почему бы под каждый запрос не написать отдельный текст?
Вопрос №2. Известно, что каждая страница должна затачиваться лишь под один ключевик, а тут мы получаем целую группу да еще в некоторых случаях с достаточно большим содержанием запросов. Как в таком случае происходит оптимизация самого текста, ведь если ключей, например, 20, тогда употребление хотя бы по одному разу каждого в тексте (даже большого размера) уже похоже на текст для поисковика, а не для людей.
Ответ. Если взять пример запросов из предыдущего вопроса, то затачиваться материал первым делом будет именно под самый частотный (1й) запрос, так как мы большего всего заинтересованы в его выходе на топовые позиции. Данный ключевик мы и считаем главным в этой группе.
Оптимизация под главную ключевую фразу происходит также, как бы это и делалось при написании текста лишь под один ключ (ключ в заголовке title, употребление нужного количества символов в тексте и нужного количества раз самого ключа, если требуется).
Касаемо других ключей, то мы их также вписываем, но не слепо, а на основе анализа конкурентов, который может показать среднее значение количества этих ключей в текстах из ТОПа. Может получиться ситуация, что для большинства ключевиков вы получите нулевые значения, а значит в точном вхождении они не требуют употребления.
Таким образом текст пишется, употребляя всего лишь главный запрос в тексте в прямом. Конечно другие запросы тоже могут быть употреблены, если анализ конкурентов покажет их наличие в текстах из ТОП. Но это никак не 20 ключевиков в тексте в их точном вхождении.
Совсем недавно публиковал материал под группу из 11 ключей. Вроде бы много запросов, но на скриншоте ниже можете видеть, что лишь главный самый частотный ключ имеет употребление точного вхождения – 6 раз. Остальные же ключевые фразы не имеют точных вхождений, но также и разбавочных (на скриншоте не видно, но в ходе анализа конкурентов это показано). Т.е. они вообще не употребляются.
(1я колонка – частотность, 2я – конкурентность, 3я – количество показов)
В большинстве случаев будет похожая ситуация, когда лишь пару ключей нужно будет употребить в точном вхождении, а все остальные либо сильно разбавлять, либо вообще не употреблять даже в разбавочном вхождении. Статья получается читаемой и нет намеков на заточку только под поиск.
Вопрос №3. Вытекает из ответа на Вопрос №2. Если остальные ключи в группе не нужно вообще употреблять, то как тогда они будут получать трафик?
Ответ. Дело в том, что по наличию определенных слов в тексте поисковик может определить о чем текст. Так как в ключевых словах имеются определенные отдельные слова, относящиеся только к этому ключу, то их и нужно употреблять в тексте определенное количество раз на основе того же анализа конкурентов.
Таким образом ключ в точном вхождении не употребится, а вот слова из ключа по отдельности в тексте присутствовать будут и в ранжировании также будут принимать участие. В итоге по этим запросам текст будет также находиться в поиске. Но и количество отдельных слов в этом случае в идеале требуется соблюдать. Помогут конкуренты.
На основные вопросы, которые могли загнать вас в ступор, я ответил. Подробнее, как оптимизировать текст под группы запросов, я напишу в одном из следующим материалов. Там будет и про анализ конкурентов и про написание самого текста под группу ключей.
Ну, а если вопросы еще остались, тогда задавайте свои комментарии. На все отвечу.
А теперь давайте начнем составление семантического ядра сайта.
Очень важно. Весь процесс, как он есть на самом деле я никак не смогу описать в этой статье (придется делать целый вебинар на 2-3 часа или мини-курс), поэтому я постараюсь быть краток, но в то же время информативным и затронуть максимальное количество моментов. Например, я не буду описывать в детальности настройку софта KeyCollector. Все будет урезано, но максимально понятно.
Теперь пройдемся по каждому пункту. Начнем. Сначала подготовка.
Что необходимо для сбора семантического ядра?
Перед тем, как составить семантическое ядро сайта, настроим кейколлектор для правильного сбора статистики и парсинга запросов.
Настройка KeyCollector
Войти в настройки можно, нажав на пиктограмму в верхнем меню софта.
Сначала то, что касается парсинга.
Хочу отметить настройки «Количество потоков» и «Использовать основной IP-адрес». Количество потоков для сбора одного небольшого ядра не нужно большое. Достаточно 2-4 потоков. Чем больше потоков, тем больше нужно прокси-серверов. В идеале 1 прокси на 1 поток. Но можно и 1 прокси на 2 потока (так парсил я).
Касаемо второй настройки, то в случае парсинга в 1-2 потока можно использовать свой основной ИП адрес. Но только,если он динамический, т.к. в случае бана статического ИП вы потеряете доступ к поисковой системе Яндекс. Но все же приоритет всегда отдается использованию прокси-сервера, так как лучше обезопасить себя.
На вкладке настроек парсинга Yandex.Direct важно добавить свои аккаунты Яндекса. Чем их будет больше, тем лучше. Можете их зарегистрировать сами или купить, как я писал ранее. Я же их приобретал, так как мне проще потратить 100 рублей за 30 аккаунтов.
Добавление можно выполнить из буфера, заранее скопировав список аккаунтов в нужном формате, или загрузить из файла.
Аккаунты нужно указывать в формате «логин:пароль» при этом в логине не указывать сам хост (без @yandex.ru). Например, «artem_konovalov:jk8ergvgkhtf».
Также, если мы используем несколько прокси-серверов, лучше закрепить их за определенными аккаунтами. Подозрительно будет, если сначала запрос идет с одного сервера и с одного аккаунта, а при следующем запросе с этого же акаунта яндекса прокси сервер уже другой.
Рядом с аккаунтами имеется столбик «IP прокси». Напротив каждого аккаунта мы и вписываем определенный прокси. Если аккаунтов 20, а прокси-серверов 2, тогда будет 10 аккаунтов с одним прокси и 10 с другим. Если 30 аккаунтов, тогда 15 с один сервером и 15 с другим. Логику, думаю, вы поняли.
Если используем всего один прокси, то нет смысла вписывать его к каждому аккаунту.
Про количество потоков и использование основного ИП адреса я говорил немного ранее.
Следующая вкладка «Сеть», на которой нужно внести прокси-сервера, которые будут использоваться для парсинга.
Вводить прокси нужно в самом низу вкладки. Можно загрузить их из буфера в нужном формате. Я же добавлял по простому. В каждую колонку строки я вписывал данные о сервере, дающиеся вам при его покупке.
Далее настраиваем параметры экспорта. Так как все запросы с их частотностями нам нужно получить в файле на компьютере, то необходимо выставить некоторые параметры экспорта, чтобы не было ничего лишнего в таблице.
В самом низу вкладки (выделил красным) нужно выбрать те данные, которые нужно экспортировать в таблицу:
- Фраза;
- Источник;
- Частотность «!» ;
- Лучшая форма фразы (можно и не ставить).
Осталось лишь настроить разгадывание антикапчи. Вкладка так и называется - «Антикапча». Выбираем используемый сервис и вводим специальный ключ, который находится в аккаунте сервиса.
Специальный ключ для работы с сервисом предоставляется в письме после регистрации, но также его можно взять из самого аккаунта в пункте «Настройки – настройки аккаунта».
На этом настройки KeyCollector выполнены. Не забываем после проделанных изменений сохранить настройки, нажав на большую кнопку внизу «Сохранить изменения».
Когда все сделано и мы готовы к парсингу, можно приступить к рассмотрению этапов сбора семантического ядра, а потом уже и проделать каждый этап в порядке очереди.
Этапы сбора семантического ядра
Получить качественное и полное семантическое ядро невозможно, используя лишь основные запросы. Также нужно анализировать запросы и материалы конкурентов. Поэтому весь процесс составления ядра состоит из нескольких этапов, которые в свою очередь еще делятся на подэтапы.
- Основа;
- Анализ конкурентов;
- Расширение готового списка с этапов 1-2;
- Сбор лучших словоформ к запросам с этапов 1-3.
Этап 1 – основа
В ходе сбора ядра на этом этапе нужно:
- Сформировать основной список запросов в нише;
- Расширение этих запросов;
- Чистка.
Этап 2 – конкуренты
В принципе, этап 1 уже дает некий объем ядра, но не в полной мере, т.к. мы можем что-то упустить. А конкуренты в нашей нише помогут найти упущенные дыры. Вот шаги, необходимые к выполнению:
- Сбор конкурентов на основе запросов с этапа 1;
- Парсинг запросов конкурентов (анализ карты сайта, открытая статистика liveinternet, анализ доменов и конкурентов в SpyWords);
- Чистка.
Этап 3 – расширение
Многие останавливаются уже на первом этапе. Кто-то доходит до 2го, но имеется же еще ряд дополнительных запросов, которые также могут дополнить семантическое ядро.
- Объединяем запросы с 1-2 этапов;
- Оставляем 10% самых частотных слов со всего списка, которые содержат минимум 2 слова. Важно, чтобы эти 10% были не более 100 фраз, т.к. большое количество заставит вас сильно закопаться в процесс сбора, чистки и группировки. Нам же нужно собрать ядро в соотношении скорость/качество (минимальные потери качества при максимальной скорости);
- Выполняем расширение этих запросов с помощью сервиса Rookee (все есть в KeyCollector);
- Чистим.
Этап 4 – сбор лучших словоформ
Сервис Rookee может для большинства запросов определить их лучшую (правильную) словоформу. Этим также нужно пользоваться. Целью не является определить то слово, которое более правильно, а найти еще некоторые запросы и их формы. Таким образом можно подтянуть еще пул запросов и использовать их при написании текстов.
- Объединение запросов с первых 3х этапов;
- Сбор по ним лучших словоформ;
- Добавление лучших словоформ в список ко всех запросам, объединенным с 1-3 этапов;
- Чистка;
- Экспорт готового списка в файл.
Как видите, все не так уж и быстро, а тем более не так просто. Это я обрисовал лишь нормальный план составления ядра, чтобы на выходе получить качественный список ключей и ничего не потерять или потерять по минимуму.
Теперь я предлагаю пройтись по каждому пункту в отдельности и проштудировать все от А до Я. Информации много, но это того стоит, если вам нужно действительно качественное семантическое ядро сайта.
Этап 1 – основа
Сперва мы формируем список основных запросов ниши. Как правило, это 1-3х словные фразы, которые описывают определенный вопрос ниши. В пример предлагаю взять нишу «Медицина», а конкретнее - поднишу сердечных заболеваний.
Какие основные запросы мы можем выделить? Все я конечно писать не буду, но парочку приведу.
- Заболевания сердца
- Инфаркт;
- Ишемическая болезнь сердца;
- Аритмия;
- Гипертония;
- Порок сердца;
- Стенокардия и т.д.
Простыми словами – это общие названия заболеваний. Таких запросов может быть достаточно много. Чем больше сможете сделать, тем лучше. Но не стоит вписывать для галочки. Бессмысленно выписывать более конкретные фразы от общих, например:
- Аритмия;
- Аритмия причины;
- Лечение аритмии;
- Аритмия симптомы.
Главной является лишь первая фраза. Остальные нет смысла указывать, т.к. они появятся в списке в ходе расширения с помощью парсинга из левой колонки Яндекс вордстат.
Для поиска общих фраз можно пользоваться, как сайтами конкурентов (карта сайта, названия разделов…), так и опытом специалиста в этой нише.
Парсинг займет некоторое время, в зависимости от количества запросов в нише. Все запросы по умолчанию помещаются в новую группу с названием «Новая группа 1», если память не изменяет. Я обычно переименовываю группы, чтобы понимать, какая за что отвечает. Меню управления группами находится справа от списка запросов.
Функция переименования находится в контекстном меню при нажатии правой кнопки мыши. Это меню понадобится еще для создания других групп на втором, третьем и четвертом этапах.
Поэтому, можете сразу добавить еще 3 группы, нажав на первую пиктограмму «+», чтобы группа создалась в списке сразу после предыдущей. Пока в них не нужно ничего добавлять. Пусть просто будут.
Называл я группы так:
- Конкуренты – понятно, что в этой группе находится список запросов, который я дособрал у конкурентов;
- 1-2 – это объединенный список запросов с 1го (основного списка запросов) и 2го (запросы конкурентов) этапов, чтобы оставить из них всего 10% запросов, состоящих минимум из 2х слов и собрать по ним расширения;
- 1-3 – объединенный список запросов с первого, второго и третьего (расширений) этапов. Также в эту группу мы собираем лучшие словоформы, хотя грамотней было бы собрать их в новую группу (например, лучшие словоформы), а затем после их чистки уже перенести в группу 1-3.
После окончания парсинга из yandex.wordstat вы получаете большой список ключевых фраз, который, как правило (ели ниша небольшая) будет в пределах нескольких тысяч. Много из этого является мусором и запросами-пустышками и придется все чистить. Что-то отсеем автоматически с помощью функционала KeyCollector, а что-то придется лопатить руками и немного посидеть.
Когда запросы все собраны, нужно собрать их точные частотности. Общая частотность собирается при парсинге, а вот точную нужно собирать отдельно.
Для сбора статистики по количеству показов можно пользоваться двумя функциями:
- С помощью Яндекс Директ – быстро, статистика собирается пачками, но имеются ограничения (например, фразы больше 7ми слов не прокатят и с символами тоже);
- С помощью анализа в Яндекс Вордстате – очень медленно, фразы анализируются по одной, но нет ограничений.
Сначала собрать статистику с помощью Директа, чтобы это было максимально быстро, а для тех фраз, по которым с Директом не получилось определить статистику, используем уже Вордстат. Как правило, таких фраз останется мало и они дособерутся быстро.
Сбор статистика показов с помощью Яндекс.Директ осуществляются при нажатии на соответствующую кнопку и назначении нужных параметров.
После нажатия на кнопку «Получить данные» может быть предупреждение, что Яндекс Директ не включен в настройках. Вам нужно будет согласиться на активацию парсинга с помощью Директа, чтобы начать определять статистику частотности.
Вы сразу увидите, как пачками в колонку «Частотность! » начнут проставляются точные показатели показов по каждой фразе.
Процесс выполнения задачи можно видеть на вкладке «Статистика» в самом низу программы. Когда задача будет выполнена, на вкладке «Журнал событий» вы увидите уведомление о завершении, а также исчезнет полоса прогресса на вкладке «Статистика».
После сбора количества показов с помощью Яндекс Директ мы проверяем, имеются ли фразы, для которых частотность не собралась. Для этого сортируем колонку «Частотность!» (нажимаем на нее), чтобы в верху стали наименьшие значения или наибольшие.
Если вверху будут все нули, тогда все частотности собранные. Если же будут пустые ячейки, тогда для этих фраз показы не определились. Тоже самое касается и при сортировке по убиванию, только тогда придется смотреть результат в самом низу списка запросов.
Начать сбор с помощью яндекс вордстат также можно, нажав на пиктограмму и выбрав необходимый параметр частотности.
После выбора типа частотности вы увидите, как постепенно начнут заполнятся пустые ячейки.
Важно: не стоит пугаться, если после конца процедуры останутся пустые ячейки. Дело в том, что пустыми они будут в случае их точной частотности менее 30. Это мы выставили в настройках парсинга в Keycollector. Эти фразы можно смело выделить (также, как и обычные файлы в проводнике Windows) и удалить. Фразы выделятся голубым цветом, нажимаем правую кнопку мышки и выбираем «Удалить выделенные строки».
Когда вся статистика собрана, можно приступить к чистке, которую очень важно делать на каждом этапе сбора семантического ядра.
Основная задача – убрать фразы не относящие к тематике, убрать фразы со стоп-словами и избавиться от слишком низкочастотных запросов.
Последнее в идеале не нужно выполнять, но, если мы будем в ходе составления сем. ядра использовать фразы даже с минимальной частотностью в 5 показов в месяц, то это увеличит ядро на процентов 50-60 (а может быть и все 80%) и заставить нас сильно закопаться. Нам же нужно получить максимальную скорость при минимальных потерях.
Если хотим получить максимально полное семантическое ядро сайта, но при этом собирать его около месяца (есть опыт совсем отсутствует), тогда берите частотности от 4-5 месячных показов. Но лучше (если новичок) оставлять запросы, которые имеют хотя бы 30 показов в месяц. Да, мы немного потеряем, но это цена за максимальную скорость. А уже в ходе роста проекта можно будет заново получить эти запросы и уже их использовать для написания новых материалов. И это только при условии, что все сем. ядро уже выписано и нет тем для статей.
Отфильтровать запросы по количеству их показов и другим параметрам позволяет все тот же кейколлектор на полном автомате. Изначально я рекомендую сделать именно это, а не удалять мусорные фразы и фразы со стоп-словами, т.к. гораздо проще будет это делать, когда общий объем ядра на этом этапе станет минимальным. Что проще, лопатить 10000 фраз или 2000?
Доступ к фильтрам находится на вкладке «Данные», нажав на кнопку «Редактировать фильтры».
Я рекомендую сначала отобразить все запросы с частотностью менее 30 и перенести их в новую группу, чтобы их не удалять, так как в будущем они могут пригодиться. Если же мы просто применим фильтр для отображения фраз с частотностью более 30, то после очередного запуска KeyCollector придется заново применять этот же фильтр, так как все сбрасывается. Конечно, фильтр можно сохранить, но все равно придется его применять, постоянно возвращаясь ко вкладке «Данные».
Чтобы избавить себя от этих действий, мы в редакторе фильтров добавляем условие, чтобы отображались фразы только с частотностью менее 30.
В будущем выбрать фильтр можно, нажав на стрелку возле пиктограммы дискеты.
Итак, после применения фильтра, в списке запросов останутся только фразы с частотностью менее 30, т.е. 29 и ниже. Также отфильтрованная колонка выделится цветом. В примере ниже вы будете видеть частотность только 30, т.к. я показываю все это на примере уже готово ядра и все почищено. На это внимания не обращайте. У вас все должно быть так, как я описываю в тексте.
Для переноса нужно выделить все фразы в списке. Нажимаем на первую фразу, Листаем в самый низ списка, зажимаем клавишу «Shift» и кликаем один раз на последнюю фразу. Таким образом выделяется все фразы и пометятся голубым фоном.
Появится небольшое окно, где необходимо выбрать именно перемещение.
Теперь можно удалить фильтр с колонки частотности, чтобы остались запросы только с частотностью 30 и выше.
Определенный этап автоматической чистки мы выполнили. Дальше придется повозиться, удалив мусорные фразы.
Сначала предлагаю указать стоп-слова, чтобы удалить все фразы с их наличием. В идеале конечно же это делается сразу на этапе парсинга, чтобы в список они и не попадали, но это не критично, так как очищение от стоп-слов происходит в автоматическом режиме с помощью Кейколлектора.
Основная сложность состоит в составлении списка стоп-слов, т.к. в каждой тематике они разные. Поэтому, делали бы мы чистку от стоп-слов в начале или сейчас – не так важно, так как стоит найти все стоп-слова, а это дело наживное и не такое уж и быстрое.
В интернете вы можете найти общетематические списки, в которые входят самые распространенные слова по типу «реферат, бесплатно, скачать, п…рно, онлайн, картинка и т.д.».
Сначала предлагаю применить общетематический список, чтобы количество фраз еще уменьшилось. На вкладке «Сбор данных» жмете на кнопку «Стоп-слова» и добавляете их списком.
В этом же окне жмем на кнопку «Отметить фразы в таблице», чтобы отметились все фразы, содержащие введенные стоп-слова. Но нужно, чтобы весь список фраз в группе был не отмечен, чтобы после нажатия на кнопку остались отмечены только фразы со стоп-словами. Снять отметки со всех фраз очень просто.
Когда останутся отмеченные только фразы со стоп-словами, мы ух либо удаляем, либо переносим в новую группу. Я в первый раз удалил, но все таки приоритетней создать группу «Со стоп-словами» и переместить в нее все лишние фразы.
После очистки, фраз стало еще меньше. Но и это не все, т.к. все равно мы что-то упустили. Как сами стоп-слова, так и фразы, не относящие к направленности нашего сайта. Это могут быть коммерческие запросы, под которые тексты не напишешь или же напишешь, но они не будут соответствовать ожиданиям пользователя.
Примеры таких запросов могут быть связаны со словом «купить». Наверняка, когда пользователь что-то ищет с этим словом, то он уже хочет попасть на сайт, где это продают. Мы же напишем текст под такую фразу, но посетителю он нужен не будет. Поэтому, такие запросы нам не нужны. Их мы ищем в ручном режиме.
Оставшийся список запросов мы не спеша и внимательно листаем до самого конца в поисках таких фраз и обнаружения новых стоп-слов. Если обнаружили какое-то слово, употребляющееся много раз, то просто добавляем его в уже существующий список стоп-слов и жмем на кнопку «Отметить фразы в таблице». В конце списка, когда по ходу ручной проверки мы отметили все ненужные запросы, удаляем отмеченные фразы и первый этап составления семантического ядра окончен.
Получили определенное семантическое ядро. Оно еще не совсем полное, но уже позволит написать максимально возможную часть текстов.
Осталось лишь добавить к нему еще небольшую часть запросов, которую мы могли упустить. В этом помогут следующие этапы.
Этап 2 – конкуренты
В самом начале мы собрали список общих фраз, относящихся к нише. В нашем случае это были:
- Заболевания сердца
- Инфаркт;
- Ишемическая болезнь сердца;
- Аритмия;
- Гипертония;
- Порок сердца;
- Стенокардия и т.д.
Все они относятся именно к нише «Болезни сердца». По этим фразам необходимо в поиске найти сайты конкурентов именно по данной теме.
Вбиваем каждую из фраз и ищем конкурентов. Важно, чтобы это были не общетематические (в нашем случае медицинские сайты общей направленности, т.е. про все болезни). Нужны именно нишевые проекты. В нашем случае - только про сердце. Ну может быть еще и про сосуды, т.к. сердце связано с сосудистой системой. Мысль, думаю, вы поняли.
Если у нас ниша «Рецепты салатов с мясом», тогда в перспективе только такие сайты и искать. Если их нет, то старайтесь найти сайты только про рецепты, а не в общем про кулинарию, где все обо всем.
Если же общетематический сайт (общемедицинский, женский, про все виды стройки и ремонта, кулинария, спорт), тогда придется очень помучиться, как в плане составления самого семантического ядра, т.к. придется долго и нудно пахать – собирать основной список запросов, долго ждать процесса парсинга, чистить и группировать.
Если на 1й, а иногда и даже на 2й странице, не удается найти узкие тематические сайты конкурентов, тогда попробуйте использовать не основные запросы, которые мы сформировали перед самим парсингом на 1м этапе, а запросы уже из всего списка после парсинга. Например:
- Как лечить аритмию народными средствами;
- Симптомы аритмии у женщин и так далее.
Дело в том, что такие запросы (аритмия, болезни сердца, порок сердца…) имеют самую высокую конкурентность и по ним выбиться в ТОП практически нереально. Поэтому, на первых позициях, а может быть и на страницах, вы вполне реально найдете только общетематические порталы обо всем в виду их огромнейшей авторитетности в глазах поисковых систем, возраста и ссылочной массы.
Так что вполне разумно использовать для поиска конкурентов более низкочастотные фразы, состоящие из большего количества слов.
Нужно спарсить их запросы. Можно использовать сервис SpyWords, но функция анализа запросов в нем доступна на платном тарифе, стоимость которого довольно большая. Поэтому для одного ядра нет смысла обновлять тариф на этом сервисе. Если нужно собрать несколько ядер на протяжении месяца, например 5-10, тогда можно купить аккаунт. Но опять же – только при наличии бюджета на тариф PRO.
Также можно использовать статистику Liveinternet, если она открыта для просмотра. Очень часто владельцы делают ее открытой для рекламодателей, но закрывают раздел «поисковые фразы», а именно он нам и нужен. Но все же имеются сайты, когда этот раздел открыт для всех. Очень редко, но имеются.
Самым простым способом является банальный просмотр разделов и карты сайта. Иногда мы можем упустить не только какие-то общеизвестные фразы ниши, но и специфические запросы. На них может и не так много материалов и под них не создашь отдельный раздел, но пару десятков статей они могут прибавить.
Когда мы нашли еще список новых фраз для сбора, запускаем тот же сбор поисковых фраз из левой колонки Яндекс Вордстат, как и на первом этапе. Только запускаем мы его уже, находясь во второй группе «Конкуренты», чтобы запросы добавлялись именно в нее.
- После парсинга собираем точные частотности поисковых фраз;
- Задаем фильтр и перемещаем (удаляем) запросы с частотностью менее 30 в отдельную группу;
- Чистим от мусора (стоп-слова и запросы, не относящиеся к нише).
Итак, получили еще небольшой список запросов и семантическое ядро стало более полным.
Этап 3 – расширение
У нас уже есть группа с названием «1-2». В нее мы копируем фразы из групп «Основной список запросов» и «Конкуренты». Важно именно скопировать, а не переместить, чтобы в предыдущих группах все фразы на всякий случай остались. Так будет безопасней. Для этого в окне переноса фраз нужно выбрать вариант «копирование».
Получили все запросы с 1-2 этапов в одной группе. Теперь нужно оставить в этой группе всего 10% самых частотных запросов от всего количества и которые содержат не менее 2х слов. Также их должно быть не более 100 штук. Уменьшаем, чтобы не закопаться в процесс сбора ядра на месяц.
Сперва применяем фильтр, в котором зададим условие, чтобы показывались минимум 2х словные фразы.
Отмечаем все фразы в оставшемся списке. Нажав на колонку «Частотность!», сортируем фразы по убыванию количества показов, чтобы в верху были самые частотные. Далее выделяем первые 10% из оставшегося числа запросов, снимаем с них отметку (правая кнопка мыши – снять отметку с выделенных строк) и удаляем отмеченные фразы, чтобы остались только эти 10%. Не забываем, что если ваши 10% будут более 100 слов, тогда на 100й строке останавливаемся, больше не нужно.
Теперь проводим расширение с помощью функции кейколлектора. Поможет в этом сервис Rookee.
Параметры сбора указываем, как на скриншоте ниже.
Сервис соберет все расширения. Среди новых фраз могут быть очень длинные ключи, а также символы, поэтому не для всех получится собрать частотность через Яндекс Директ. Придется потом дособрать статистику с помощью кнопки от вордстата.
После получения статистики убираем запросы с месячными показами менее 30 и проводим чистку (стоп-слова, мусор, неподходящие к нише ключи).
Этап закончен. Получили еще список запросов.
Этап 4 – сбор лучших словоформ
Как говорил ранее, целью не является определить такую форму фразы, которая будет более правильной.
В большинстве случаев (исходя из моей практики) сбор лучших словоформ укажет на ту же фразу, что и имеется в списке запросов. Но, без сомнения, будут и такие запросы, к которым будет указана новая словоформа, которой еще нет в семантическом ядре. Это дополнительные ключевые запросы. Этим этапом мы добиваем ядро до максимальной полноты.
При сборе своего ядра данный этап дал еще 107 дополнительных запросов.
Сперва мы копируем ключи в группу «1-3» из групп «Основные запросы», «Конкуренты» и «1-2». Должна получиться сумма всех запросов со всех ранее проделанных этапов. Далее используем сервис Rookee по той же кнопке, что и делали расширение. Только выбираем другую функцию.
Начнется сбор. Фразы будут добавляться в новую колонку «Лучшая форма фразы ».
Лучшая форма будет определена не ко всем фразам, так как сервис Rookee попросту не знает все лучшие формы. Но ля большинства результат будет положительным.
Когда процесс окончен, нужно добавить эти фразы ко всему списку, чтобы они находились в той же колонке «Фраза». Для этого выделяете все фразы в колонке «Лучшая форма фразы», копируете (правая кнопка мыши - копировать), далее жмете на большую зеленую кнопку «Добавить фразы» и вносите их.
Убедиться в том, что фразы появились в общем списке очень просто. Так как при подобном добавлении фраз в таблицу происходит в самый низ, то листаем в самый низ списка и в колонке «Источник» мы должны видеть иконку кнопки добавления.
Фразы, добавленные с помощью расширений, будут помечены иконкой руки.
Так как частотность для лучших словоформ не определена, то нужно это сделать. Аналогично предыдущим этапам выполняем сбор количества показов. Не бойтесь, что сбор осуществляем в той же группе, где находятся остальные запросы. Сбор просто продолжится для тех фраз, которые имеют пустые ячейки.
Если вам будет удобней, тогда изначально вы можете добавить лучшие словоформы не в ту же группу, где они и были найдены, а в новую, чтобы там были только они. И уже в ней собрать статистику, очистить от мусора и так далее. А уже потом оставшиеся нормальные фразы добавить ко всему списку.
Вот и все. Семантическое ядро сайта собрано. Но работы еще осталось немало. Продолжаем.
Перед следующими действиями нужно выгрузить все запросы с необходимыми данными в excel файл на компьютер. Настройки экспорта мы выставили ранее, поэтому можно сразу его и сделать. За это отвечает пиктограмма экспорта в главном меню KeyCollector.
Открыв файл, должны получить 4 колонки:
- Фраза;
- Источник;
- Частотность!;
- Лучшая форма фразы.
Это наше итоговое семантическое ядро, содержащее максимальный чистый и необходимый список запросов для написания будущих текстов. В моем случае (узкая ниша) получилось 1848 запросов, что равняется приблизительно 250-300 материалам. Точно сказать не могу - полностью еще на разгруппировал все запросы.
Для немедленного применения это еще сырой вариант, т.к. запросы находятся в хаотичном порядке. Нужно еще раскидать их по группам, чтобы в каждой были ключи к одной статье. Это и является окончательной целью.
Разгруппировка семантического ядра
Этот этап выполняется довольно быстро, хотя и с некоторыми сложностями. Поможет нам сервис http://kg.ppc-panel.ru/ . Имеются и другие варианты, но будем использовать этот в виду того, что с ним мы сделаем все в соотношении качество/скорость. Тут нужна не скорость, а в первую очередь качество.
Очень полезной вещью сервиса является запоминание всех действий в вашем браузере по кукам. Если даже, вы закроете эту страницу или браузер в целом, то все сохранится. Таким образом нет нужды делать все за один раз и бояться, что в один момент может все пропасть. Продолжить можно в любое время. Главное не чистить куки браузера.
Пользование сервисом я покажу на примере нескольких выдуманных запросов.
Переходим на сервис и добавляем все семантическое ядро (все запросы из excel файла), экспортированное ранее. Просто копируем все ключи и вставляем их в окно, как показано на изображении ниже.
Они должны появится в левой колонке «Ключевые слова».
На наличие закрашенных групп в правой стороне не обращайте внимание. Это группы из моего предыдущего ядра.
Смотрим на левую колонку. Имеется добавленный список запросов и строка «Поиск/фильтр». Фильтром мы и будем пользоваться.
Технология очень проста. Когда мы вводим часть какого-то слова или фразы, то сервис в режиме реального времени оставляет в списке запросов только те, что содержат введенное слово/фразу в самом запросе.
Более наглядно смотрите ниже.
Я хотел найти все запросы, относящиеся к аритмии. Ввожу слово «Аритмия» и сервис автоматически оставляет в списке запросов только те, что содержат введенное слово или его часть.
Фразы переместятся в группу, которая будет называться одной из ключевых фраз этой группы.
Получили группу, где лежат все ключевые слова по аритмии. Чтобы увидеть содержимое группы, кликните на нее. Немного позже мы будем эту группу еще разбивать на более мелкие группы, так как с аритмией есть очень много ключей и все они под разные статьи.
Таким образом на начальном этапе группировки нужно создать большие группы, которые объединяют большое количество ключевых слов из одного вопроса ниши.
Если взять в пример ту же тематику сердечных болезней, тогда сначала я буду создавать группу «аритмия», потом «порок сердца», затем «инфаркт» и так далее пока не будет групп по каждой из болезни.
Таких групп, как правило, будет практически столько же, сколько и основных фраз ниши, сгенерированных на 1м этапе сбора ядра. Но в любом случае, их должно быть больше, так как имеются еще фразы с 2-4го этапов.
Некоторые группы могут содержать вообще 1-2 ключа. Это может быть связано, например с очень редким заболеванием и про него никто не знает или никто не ищет. Поэтому и запросов нет.
В общем, когда основные группы созданы, необходимо их разбить на более мелкие группы, которые и будут использованы для написания отдельных статей.
Внутри группы напротив каждой ключевой фразы есть крестик, нажав на который, фраза удаляется из группы и обратно попадает в неразгруппированный список ключевых слов.
Таким образом и происходит дальнейшая группировка. Покажу на примере.
На изображении вы можете видеть, что имеются ключевые фразы, связанные с лечением аритмии. Если мы хотим их определить в отдельную группу для отдельной статьи, тогда удалям их из группы.
Они появятся в списке левой колонки.
Если в левой колонке еще присутствуют фразы, тогда, чтобы найти удаленные ключи из группы, придется применить фильтр (воспользоваться поиском). Если же список полностью находится по группам, тогда там будут только удаленные запросы. Мы их отмечаем и жмем на «Создать группу».
В колонке «Группы» появится еще одна.
Таким образом мы распределяем все ключи по темам и под каждую группу в конечно итоге пишется отдельная статья.
Единственная сложность сего процесса заключается в анализе необходимости разгруппировки некоторых ключевиков. Дело в том, что имеются ключи, которые по своей сути разные, но они не требуют написания отдельных текстов, а пишется подробный материал по многих вопросам.
Это ярко выражено именно в медицинской тематике. Если взять пример с аритмией, то нет смысла делать ключи «аритмия причины» и «аритмия симптомы». Ключи про лечение аритмии еще под вопросом.
Узнается это после анализа поисковой выдачи. Заходим в поиск Яндекса и вбиваем анализируемый ключ. Если видим, что в ТОПе находятся статьи, посвященные только симптомам аритмии, тогда данный ключ выделяем в отдельную группу. Но, если же тексты в ТОПе раскрывают все вопросы (лечение, причины, симптомы, диагностика и так далее), тогда разгруппировка в данном случае не нужна. Все эти темы раскрываем в рамках одной статьи.
Если в Яндексе находятся именно такие тексты на верхушке выдачи, тогда это знак, что разгруппировку делать не стоит.
Тоже самое можно привести на примере ключевой фразы «причины выпадения волос». Могут быть подключи «причины выпадения волос у мужчин» и «…у женщин». Очевидно, что под каждый ключ можно написать отдельный текст, если исходить из логики. Но о чем скажет Яндекс?
Вбиваем каждый ключ и смотрим, какие же тексты там присутствуют. Под каждый ключ там отдельные подробные тексты, тогда ключи разгруппированием. Если же в ТОПе по обеим запросам находятся общие материалы по ключу «причины выпадения волос», внутри которого раскрыты вопросы касаемо женщин и мужчин, тогда оставляем ключи в рамках одной группы и публикуем один материал, где раскрываются темы по всем ключам.
Это важно, так как поисковая система не зря определяет тексты в ТОП. Если на первой странице находятся исключительно подробные тексты по определенному вопросу, тогда велика вероятность, что разбив большую тему на подтемы и написав по каждой материал, вы не попадаете в ТОП. А так один материал имеет все шансы получить хорошие позиции по всем запросам и собирать по ним хороший трафик.
В медицинских тематиках этому моменту нужно уделять много внимания, что значительно усложняет и замедляет процесс разгруппировки.
В самом низу колонки «Группы» имеется кнопка «Выгрузить». Жмем на нее и получаем новую колонку с текстовым полем, содержащим все группы, разделенные между собой строчным отступом.
Если не все ключи находятся в группах, то в поле «Выгрузка» пробелов между ними не будет. Они появляются только при полностью выполненной разгруппировке.
Выделяем все слова (комбинация клавиш Ctrl+A), копируем их и вставляем в новый excel файл.
Ни в коем случае не жмем на кнопку "Очистить все", так как удалится абсолютно все, что вы проделали.
Этап разгруппировки окончен. Теперь можно смело писать по тексту под каждую группу.
Но, для максимальной эффективности, если бюджет вам не позволяет выписать все сем. ядро за пару дней, а имеется лишь строго ограниченная возможность для регулярной публикации небольшого количества текстов (10-30 в месяц, к примеру), тогда стоит определить конкуренцию всех групп. Это важно, так как группы с наименьшей конкуренцией дают результат в первые 2-3-4 месяца после написания без каких-либо ссылок. Достаточно лишь написать качественный конкурентноспособный текст и правильно его оптимизировать. Дальше за вас все сделает время.
Определение конкуренции групп
Сразу хочу отметить, что низко-конкурентный запрос или группа запросов не означает, что они являются сильно микро низкочастотными. Вся прелесть и есть в том, что достаточно приличное количество запросов, которые имеют низкую конкуренцию, но при этом обладают высокой частотностью, что сразу же дает выход такой статье в ТОП и привлечение солидного трафика на один документ.
Например, вполне реальная картина, когда группа запросов имеет конкуренцию 2-5, а частотность порядка 300 показов в месяц. Написав всего 10 таких текстов, после выхода их в ТОП, мы будем получать 100 посетителей ежедневно минимум. И это всего 10 текстов. 50 статей – 500 посещений и эти цифры взяты и потолка, так как это берется в учет лишь трафик по точным запросам в группе. Но привлекаться же трафик будет еще и по другим хвостам запросов., а не только по тем, что находятся в группах.
Вот почему так важно определить конкуренцию. Иногда вы можете видеть ситуацию, когда на сайте 20-30 текстов, а уже 1000 посещений. И причем сайт молодой и ссылок нет. Теперь вы знаете, с чем это связано.
Конкуренцию запросов можно определять через тот же KeyCollector абсолютно бесплатно. Это очень удобно, но в идеале данный вариант не являются правильным, так как формула определения конкурентности постоянно меняется с изменением алгоритмов поисковых систем.
Лучше определять конкуренцию с помощью сервиса http://mutagen.ru/ . Он платный, но более максимально приближенный к реальным показателям.
100 запросов стоят всего 30 рублей. Если у вас ядро на 2000 запросов, тогда вся проверка обойдется в 600 рублей. В сутки дается 20 бесплатных проверок (только тем, кто пополнил баланс на любую сумму). Можете каждый день оценивать по 20 фраз, пока не определите конкурентность всего ядра. Но это очень долго и глупо.
Поэтому, я пользуюсь именно мутагеном и ни имею к нему никаких претензий. Иногда бывают проблемы, связанные со скоростью обработки, но это не так критично, так как даже закрыв страницу сервиса, проверка продолжается в фоновом режиме.
Сам анализ сделать очень просто. Регистрируемся на сайте. Пополняем баланс любым удобным способом и по главному адресу (mutagen.ru) доступна проверка. В поле водим фразу и она сразу же начинает оцениваться.
Видим, что по проверяемому запросу конкурентность оказалась более 25. Это очень высокий показатель и может равняться любому числу. Сервис не отображает его реальным, так как это не имеет смысла в виду того, что такие конкурентные запросы практически нереально продвинуть.
Нормальный уровень конкуренции считается до 5. Именно такие запросы легко продвигаются без лишних телодвижений. Чуть более высокие показатели тоже вполне приемлемы, но запросы со значениями более 5 (например, 6-10) стоит использовать после того, как уже написали тексты под минимальную конкурентность. Важен максимально быстрый текста в ТОП.
Также во время оценки определяется стоимость клика в Яндекс.Директ. По ней можно оценить ваш будущий заработок. Во внимание берем гарантированные показы, значение которых можем смело делить на 3. В нашем случае можно сказать, что один клик по рекламе Яндекс директа нам будет приносить 1 рубль.
Сервис определяет и количество показов, но на них мы не смотрим, так как определяются частотность не вида "!запрос", а только "запрос". Показатель получается не точным.
Такой вариант анализа подойдет, если мы хотим проанализировать отдельный запрос. Если нужна массовая проверка ключевых фраз, тогда на главной странице сверху поля ввода ключа имеется специальная ссылка.
На следующей странице создаем новое задание и добавляем список ключей из семантического ядра. Берем их из того файла, где ключи уже разгруппированы.
Если на балансе достаточно средств для анализа, проверка сразу начнется. Продолжительность проверки зависит от количества ключей и может занять некоторое время. 2000 фраз я анализировал порядка 1го часа, когда во второй раз проверка всего 30 ключей заняла аж несколько часов.
Сразу после запуска проверки вы увидите задание в списке, где будет колонка "Статус". По ней вы и поймете, готово ли задание или нет.
Кроме этого после выполнения задания вы сразу сможете скачать файл со список всех фраз и уровнем конкуренции для каждой. Фразы будут все в таком порядке, как они и были разгруппированы. Единственное, будут удалены пробелы между группами, но это не страшно, т.к.все будет интуитивно понятно, ведь каждая группа содержит ключи на другую тему.
Кроме этого, если задание еще не выполнилось, вы можете зайти внутрь самого задания и посмотреть результаты конкуренции для уже выполненных запросов. Просто нажмите на название задания.
В пример покажу результат проверки группы запросов для семантического ядра. Собственно, эта та группа, под которую писалась данная статья.
Видим, что практически все запросы имеют максимальную конкуренцию 25 или же ближе к ней. Это значит, что по этим запросам, мне либо вообще не видать первых позиций или же не видать их очень долго. Такой материал бы на новом сайте я вообще не писал.
Сейчас же я его опубликовал только для создания качественного контента на блог. За цель конечно ставлю вывести в топ, но это уже позже. Если на первую страницу хотя бы лишь по главному запросу мануал и выйдет, тогда я уже могу рассчитывать не солидный трафик только на эту страницу.
Последним шагом осталось создать окончательный файл, на который мы и будем смотреть в процессе наполнения сайта. Семантическое ядро сайта то уже собрано, но вот управляться с ним не совсем удобно пока.
Создание финального файла со всеми данными
Нам снова понадобится KeyCollector, а также последний файл excel, который мы получили с сервиса mutagen.
Открываем ранее полученный файл и видим примерно следующее.
Из файла нам потребуются только 2 колонки:
- ключ;
- конкуренция.
Можно просто удалить все остальное содержимое из этого файла, чтобы остались только необходимые данные или же создать совсем новый файл, сделать там красивую строку заголовка с наименованием колонок, выделив ее, например, зеленым цветом, и в каждую колонку скопировать соответствующие данные.
Далее копируем все семантическое ядро из этого документа и снова добавляем его в кейколлектор. Потребуется заново собрать частотности. Это нужно, чтобы собрались частотности в таком порядке, как и расположены ключевые фразы. Ранее мы их собирали, чтобы отсеять мусор, а сейчас для создания финального файла. Фразы конечно же добавляем в новую группу.
Когда частотности собраны, мы экспортируем файл из весь столбик с частотностью копируем в финальный файл, где будут 3 колонки:
- ключевая фраза;
- конкурентность;
- частотность.
Теперь осталось немного посидеть и для каждой группы посчитать:
- Средний показатель частотности группы - важен не показатель каждого ключа, а средний показатель группы. Считается, как обычное среднеарифметическое (в excel - функция "СРЗНАЧ");
- Общую частотность группы поделить на 3, чтобы привести возможный трафик к реальным цифрам.
Чтобы вам не мучиться с освоением расчетов в excel, я подготовил для вас файл, куда вам просто в нужные колонки нужно внести данные и все будет посчитано на полном автомате. Каждую группу нужно рассчитывать в отдельности.
Внутри будет простой пример расчета.
Как видите, все очень просто. Из финального файла просто копируете все фразы группы целиком со всеми показателями и вставляете в этот файл на место предыдущих фраз с их данными. И автоматически произойдет расчет.
Важно, чтобы колонки в финальном файле и в моем были именно в таком порядке. Сначала фраза, потом частотность, а уже потом только конкуренция. Иначе, насчитаете ерунду.
Далее придется немного посидеть, чтобы создать еще один файл или лист (рекомендую) внутри файла со всеми данными о каждой группе. Этот лист будет содержать не все фразы, а лишь главную фразу группы (по ней мы будем определять, что за группа) и посчитанные значения группы из моего файла. Это своего рода окончательный файл с данными о каждой группе с посчитанными значениями. На него я и смотрю, когда выбирают тексты для публикации.
Получится все те же 3 колонки, только без каких-либо подсчетов.
В первую мы вставляем главную фразу группы. В принципе, можно любую. Она нужна лишь для того, чтобы ее скопировать и через поиск найти местоположение всех ключей группы, которые находятся на другом листе.
Во вторую мы копируем посчитанное значение частотности из моего файла, а в третью - среднее значение конкуренции группы. Берем мы эти числа из строки "Результат".
В итоге получится следующее.
Это 1й лист. На втором листе находится все содержимое финального файла, т.е. все фразы с показателями их частотности и конкуренции.
Теперь мы смотрим на 1й лист. Выбираем максимально "рентабельную" группу ключей. Копируем фразу из 1й колонки и находим ее с помощью поиска (Ctrl+F) во втором листе, где рядом с ней будут находиться остальные фразы группы.
Вот и все. Мануал подошел к концу. На первый взгляд все очень сложно, но на самом деле - достаточно просто. Как уже говорил в самом начале статьи - стоит лишь начать делать. В будущем я планирую сделать видео-мануал по этой инструкции.
Ну а на этой ноте я заканчиваю инструкцию.
Все, друзья. Буду какие-то пожелания, вопросы - жду в комментариях. До связи.
P. S. Рекорд по объему контента. В Word получилось более 50 листов мелким шрифтом. Можно было не статью публиковать, а создать книгу.
С уважением, Константин Хмелев!
Всем привет! Когда ведешь блог или контентный сайт, всегда есть необходимость в составлении семантического ядра для сайта, кластера или статьи. Для удобства и системности лучше работать с семантическим ядром по отлаженной схеме.
В этой статье мы рассмотрим:
- как происходит сбор семантического ядра для написания статьи;
- какие сервисы можно и нужно использовать;
- как правильно вписывать ключи в статью;
- мой личный опыт подбора СЯ.
Как собрать семантическое ядро онлайн
- Первым делом, нам нужно использовать сервис от Яндекс — . Здесь мы сделаем первоначальную выборку возможных ключей.
В этой статье, я буду собирать СЯ на тему, «как укладывать ламинат». Подобным образом можно использовать эту инструкцию по составлению семантического ядра для любой темы.
- Если наша статья будет на тему «как укладывать ламинат», то мы введем этот запрос для получения информации о частотности в wordstat.yandex.ru .
Как мы видим, помимо целевого запроса нам выпало много похожих запросов содержащих фразу «укладывать ламинат» , тут можно от сеять все лишнее, все ключи, которые не будут рассмотрены в нашей статье. Например, мы не будем писать на схожие темы, такие как «сколько стоит уложить ламинат» , «неровно уложили ламинат» и т. п.
Для избавления от множества заведомо не подходящих запросов, рекомендую использовать оператор «-» (минус) .
- Подставляем минус, а после него все слова не в тему.

- Теперь, выделяем все что осталось и копируем запросы в блокнот или в Word.

- Вставив все в файл Word, пробегаемся глазками и удаляем все, что не будет раскрыто в нашей статье, если встречаются ложные запросы, то проверить на наличие их в документе поможет сочетание клавиш Ctrl+F , открывается окно (боковая панель слева), куда мы вводим искомые слова.
Первая часть работы выполнена, теперь можно проверить нашу заготовку семантического ядра Яндекс на чистую частотность, в этом нам поможет оператор кавычки.
Если слов мало, то это легко сделать прямо в вордстат, подставив фразу в кавычках и найдя чистую частотность (кавычки показывают, сколько было запросов с содержанием именно этой фразы, без дополнительных слов) . А если, как в нашем примере семантического ядра статьи или сайта, получилось много слов, то лучше автоматизировать эту работу с помощью сервиса Мутаген .
Для избавления от цифр используйте следующие действия с документом Ворд.
- Ctrl+A — для выделения всего содержимого документа.
- Ctrl+H — вызывает окно для замены символов.
- Подставляем в первую строку ^# и жмем «заменить все» эта комбинация удалит все цифры из нашего документа.
Будьте осторожны с ключами, которые содержат цифры, вышеперечисленные действия могут изменить ключ.
Подбор семантического ядра для сайта/статьи онлайн
Итак, подробно о сервисе я писал . Здесь мы продолжим обучение составлению семантического ядра.
- Заходим на сайт и пользуемся этой программой для составления семантического ядра, так как более лучшей альтернативы я не встречал .
- Сначала отпарсим чистую частотность для этого проходим «парсер вордстат» → «массовый парсинг»

- Вставляем все наши отобранные слова из документа в окно парсера (Ctrl+C и Ctrl+V) и выбираем «Частотность вордстат» в кавычках .

Данная автоматизация процессов стоит всего 2 копейки за фразу ! Если вы подбираете семантическое ядро для интернет магазина, то такой подход вам сэкономит время за сущие копейки!
- Жмем отправить на проверку и, как правило через 10-40 секунд (в зависимости от количества слов) вы сможете скачать слова уже имеющие частотность в кавычках.
- Файл на выходе имеет расширение.CSV он открывается в Эксель. Начинаем фильтровать данные чтобы сделать семантическое ядро онлайн.

- Дописываем третью колонку, она нужна для выставления конкуренции (в следующем шаге).
- Ставим фильтр по всем трем столбцам.
- Отфильтровываем «по убыванию» столбец «частотность».
- Все что имеет частотность ниже 10 — удаляется .
Мы получили список ключей , который можем использовать в тексте статьи, но для начала необходимо проверить их на конкуренцию . Ведь если эта тема изъезжена в интернете вдоль и поперек, имеет ли смысл писать по данному ключу статью? Вероятность, что наша статья по нему выйдет в ТОП, крайне мала!
- Для проверки конкуренции онлайн семантического ядра заходим в «конкуренция».

- Начинаем проверять каждый запрос и полученную величину конкуренции подставляем в соответствующий столбец в нашем файле эксель.
Стоимость проверки одной ключевой фразы составляет 30 копеек .
После первого пополнения баланса, вам будет доступно 10 бесплатных проверок каждые сутки.
Для определения фраз, которые стоят для написания статьи берите наилучшее соотношение частотность-конкуренция .
Писать статью стоит:
- частотность не менее 300;
- конкуренция не выше 12 (лучше меньше).
Составление семантического ядра онлайн применяя низкоконкурентные фразы даст вам трафик. Если у вас новый сайт, то он появиться не сразу придется ждать от 4 до 8 месяцев.
Почти в любой тематике можно найти СЧ и ВЧ с низкой конкуренцией от 1 до 5, по таким ключам реально в день получать от 50 посетителей.
Для кластеризации запросов семантического ядра используйте , они помогут вам сделать правильную структуру сайта.
Куда вставлять семантическое ядро в тексте
После сбора семантического ядра для сайта пора вписать ключевые фразы в текст и вот несколько рекомендаций для начинающих, и тех, кто «не верит» в существование поискового трафика.
Правила вписывания в текст ключевых слов
- Ключ достаточно употребить 1 раз;
- слова можно склонять по падежам, менять местами;
- можно разбавлять фразы другими словами, хорошо, когда все ключевые фразы разбавлены и читабельны;
- можно убирать/заменять предлоги и вопросительные слова (как, что, зачем и т. д.);
- можно вставлять во фразу знаки «-» и «:»
например:
есть ключ: «Как уложить ламинат своими руками»
в тексте он может выглядеть так: «…для того, чтобы уложить доски ламината своими руками нам потребуется…»
или так, «Каждый, кто пытался уложить ламинат своими собственными руками…»
.
Некоторые фразы уже содержат в себе другие
, например фраза:
«как уложить ламинат своими руками на кухне»
уже содержит в себе ключевую фразу «как уложить ламинат своими руками»
. В таком случае, разрешается опустить вторую, так как она уже присутствует в тексте. Но если ключей мало
, то лучше ее также употребить в тексте или в Title, или в Description.
- если не получается впихнуть фразу в текст, то оставьте, не делайте этого (минимум две фразы можно употребить в Title и Description и не писать их в тело статьи);
- Обязательно , одна фраза — это название статьи (самая жирная частотность-конкуренция) , на языке вебмастеров — это H1, эту фразу достаточно употребить один раз в теле текста.
Противопоказания к в писанию ключей
- нельзя разделять ключевую фразу запятой (только в крайнем случае) или точкой;
- нельзя вписывать ключ в текст в прямом виде так, что он будет смотреться не естественно (не читабельно);
Заголовок и описание страницы
Title и Description — это заголовок и описание страницы, они не видны в статье, их показывает Яндекс и Google при поисковой выдаче пользователю.
Правила написания:
- заголовок и описание должны быть «журналистские», то есть привлекательны для перехода;
- содержать в себе тематический (релевантный запросу) текст, для этого вписываем в заголовок и в описание ключевые фразы (разбавленные).
Общие требования по количеству символов у плагина All in one SEO pack , следующие:
- Title — 60 символов (включая пробелы).
- Description — 160 символов (включая пробелы).
Проверить на плагиат свое творение или полученное от можно с помощью .
На этом с темой, что делать с семантическим ядром после составления мы разобрались. В заключении поделюсь собственным опытом.
После составления семантического ядра по инструкции — мой опыт
Вы можете подумать, что я Вам втюхиваю что-то не правдоподобное. Чтобы не быть голословным вот скриншот статистики за последний, (но не единственный) год этого сайта, как мне удалось перестроить блог и начать получать трафик.

Это обучение составлению семантического ядра хоть и длинное но действенное, ведь в сайтостроении главное правильный подход и терпение!
Если остались вопросы или есть критика, то пишите в комментарии, мне будет интересно, также делитесь своим опытом!


